Speech-to-Text: Wie Spracherkennung arbeitet, was sie kostet
Sprechen Sie einen Satz in Ihr Smartphone und sehen Sie zu, wie die Wörter erscheinen. Dann sehen Sie, wie sich das dritte Wort ändert, sobald Sie das fünfte ausgesprochen haben. In diesem Flackern steckt das ganze Fachgebiet im Kleinen: Eine Maschine schließt eine Wette ab und korrigiert sie, sobald neue Hinweise eintreffen.
Speech-to-Text ist inzwischen so alltäglich, dass kaum jemand fragt, was dahintersteckt. Die Technik untertitelt Videos, nimmt Schadensmeldungen für Versicherungen auf, beantwortet Anrufe in Telefonmenüs, schreibt klinische Notizen und protokolliert still mit, was das Mikrofon in Ihrem Auto hört. Sie scheitert aber auch auf eine Weise, die zufällig wirkt, bis man die Mechanik versteht – danach wirkt sie fast zwangsläufig.
Dieser Artikel klärt deshalb, was der Begriff umfasst, was zwischen Ihrem Mund und dem Bildschirm passiert, wie genau Spracherkennung tatsächlich ist, wer sie im großen Stil nutzt, was sie kostet und was sich zuletzt verändert hat. Eine Produktrangliste gibt es hier nicht.
Was ist Speech-to-Text? Mehr, als die meisten denken
Speech-to-Text bedeutet, gesprochene Sprache in geschriebenen Text umzuwandeln. Der Fachbegriff lautet automatische Spracherkennung, kurz ASR (Automatic Speech Recognition), und beide Ausdrücke meinen genau dasselbe. Entwickler und Anbieter sagen ASR; alle anderen sagen Speech-to-Text, Sprache zu Text oder Spracheingabe, je nach Gewohnheit.
Der häufigste Denkfehler: Speech-to-Text für eine Produktkategorie zu halten. Das ist es nicht, sondern eine Fähigkeit, die in vielen Produkten steckt – in zwei Modi, die sich völlig unterschiedlich anfühlen.
Der Live-Modus läuft, während der Ton noch ankommt. Die Wörter erscheinen einen Sekundenbruchteil nach dem Gesprochenen auf dem Bildschirm – in einer Diktier-App, einem Untertitelsystem, hinter dem Mikrofonsymbol einer Suchleiste. Vorher wird nichts gespeichert; das Audio wird verarbeitet, während es eintrifft.
Der Datei-Modus arbeitet mit einer Aufnahme, die bereits existiert. Sie liegt komplett vor, also kann das System vor- und zurückspringen, bevor es sich auf ein Wort festlegt. Diesen Modus nutzen Sie, wenn Sie nach einem Meeting oder Interview eine Aufnahme in ein Dokument verwandeln – eine verwandte Aufgabe mit eigenem Ablauf.
Vier Technologien, die ständig verwechselt werden
Suchergebnisse zu Speech-to-Text sind voll von drei benachbarten Technologien, die tatsächlich ganz andere Aufgaben erfüllen. Es lohnt sich, sie einmal sauber auseinanderzuhalten.
Die tückischste Verwechslung betrifft die Stimmerkennung. Umgangssprachlich meint sie dasselbe wie Spracherkennung. Streng genommen bezeichnet sie die andere Hälfte des Problems: nicht, was gesagt wurde, sondern wer es gesagt hat. Ein Stimmabdruck-System vergleicht die körperlichen Merkmale einer Stimme mit einer hinterlegten Probe, um die Identität zu bestätigen – das passiert, wenn eine Bank sagt: „Meine Stimme ist mein Passwort.“ Sprecheridentifikation und Diarisierung (die Zuordnung von Sprechern) gehören zur selben Familie. Sie liefern die Person, nicht die Wörter, und sie laufen unabhängig von der Spracherkennung. Deshalb kann ein Transkript den falschen Sprecher nennen und trotzdem jedes Wort richtig schreiben.
| Technologie | Welche Frage sie beantwortet | Eingabe → Ausgabe | Wo Sie ihr begegnen |
|---|---|---|---|
| Speech-to-Text (ASR) | Welche Wörter wurden gesprochen? | Audio → Text | Diktat, Untertitel, Meeting-Transkripte, Telefonmenüs |
| Stimmerkennung / Sprecher-ID | Wer spricht? | Audio → eine Identität oder ein Label | Telefonbanking per Stimme, Labels wie „Sprecher 2“, forensischer Abgleich |
| Text-to-Speech (TTS) | Wie soll dieser Text klingen? | Text → Audio | Screenreader, Hörbücher, Antworten von Sprachassistenten, IVR-Ansagen |
| Sprachverstehen (Spoken Language Understanding) | Was war gemeint, und was soll passieren? | Text (oder Audio) → Absicht und Aktion | „Stell einen Timer“, Anrufweiterleitung, Copiloten für Agents |
Text-to-Speech ist das saubere Spiegelbild: eine Stimme, die aus Text erzeugt wird, statt Text aus einer Stimme. Sprachverstehen setzt auf der Erkennung auf: Liegen die Wörter vor, muss noch etwas entscheiden, dass „Schieb das auf nächsten Donnerstag“ eine Terminanfrage ist. Ein smarter Lautsprecher verkettet drei der vier Technologien in weniger als einer Sekunde – deshalb erleben Menschen sie als eine einzige Sache.
Wie funktioniert Spracherkennung?
Die naheliegende Vorstellung – der Computer gleicht jeden Laut mit einem Wörterbucheintrag ab – ist falsch. Und alles, was Sie tun können, um bessere Ergebnisse zu bekommen, folgt aus dem Grund dafür.
Ein Spracherkenner identifiziert Wörter nicht einzeln. Er sucht die Folge von Wörtern, die den empfangenen Ton am wahrscheinlichsten erzeugt hat, und bewertet Kandidaten nach zwei Kriterien zugleich: wie gut sie zum akustischen Befund passen und wie plausibel sie als Sprache sind. Klassische Systeme hielten diese Teile getrennt – ein akustisches Modell, das Töne auf Phoneme abbildet, ein Aussprachelexikon und ein Sprachmodell, das Wortfolgen bewertet. Moderne End-to-End-Systeme trainieren die ganze Kette als ein einziges Netz, das direkt Text-Token ausgibt. Die Rechnung dahinter ist aber derselbe Balanceakt.
Diese Balance erklärt den berühmtesten Witz des Fachs. Im Englischen klingen „recognize speech“ (Sprache erkennen) und „wreck a nice beach“ (einen schönen Strand ruinieren) fast identisch. Nur die Sprachseite löst das Patt auf, und zwar mit der Frage, welche Formulierung Menschen tatsächlich sagen. Denkt man das weiter, ergibt sich das Verhalten, das allen auffällt: Das System repariert ein genuscheltes Wort, weil die Wörter drumherum die Antwort offensichtlich machen.
Sie erklärt auch den Fehler, der am meisten nervt. Sagen Sie den Nachnamen einer Kollegin oder einen internen Produktnamen, den das Modell im Training nie gesehen hat, kann es ihn nicht ausgeben – nicht „will nicht“, sondern „kann nicht“. Es setzt das Nächstliegende ein, das es kennt, und macht weiter. Die Abhilfe heißt kontextuelles Biasing und wird als eigenes Wörterbuch, benutzerdefiniertes Vokabular oder Word Boost verkauft: Sie geben dem System eine kurze Liste von Begriffen, und es gewichtet die Suche zu deren Gunsten. In den meisten Tools ist das die Einstellung mit der größten Hebelwirkung – und die, die man als Letztes findet.
Zehn Minuten Einrichtung, die Ihr Urteil über ein Tool verändern: Bevor Sie eine Speech-to-Text-App bewerten, tragen Sie zwanzig Begriffe in ihr eigenes Vokabular ein – Nachnamen aus dem Team, Produktnamen, die Abkürzungen Ihrer Branche, Ihre zwei größten Kunden. Die meisten testen am ersten Tag, sehen einen Namen dreimal verstümmelt und schließen daraus, die Technik tauge nichts. Das stimmt nicht. Sie kennt Ihre Welt nur noch nicht.
Live oder nachträglich: zwei verschiedene Aufgaben
Hier trennen sich die beiden Modi, und hier beginnt der größte Teil der Verwirrung über Qualität. Ein System, das eine fertige Datei verarbeitet, kann nach vorn schauen. Es kennt das Satzende, bevor es sich auf den Satzanfang festlegt, und das ist ein erheblicher Vorteil: Dieselbe akustische Mehrdeutigkeit lässt sich mit drei Sekunden Kontext aus der Zukunft viel leichter auflösen. Deshalb schneidet die Verarbeitung einer Aufnahme in der Regel besser ab als die Live-Erfassung desselben Audios. Das Produkt ist nicht schlechter; die Aufgabe ist schwerer.
Ein Live-System kann nicht in die Zukunft schauen. Es muss sofort etwas ausgeben, also zeigt es eine Teilhypothese – seine derzeit beste Vermutung – und korrigiert sie, während weiteres Audio eintrifft. Diese Korrekturen sind die Wörter, die sich auf dem Bildschirm selbst umschreiben. Das ist kein Fehler, sondern das ehrliche Abbild eines Systems, das seine Wette aktualisiert.
Zwei Mechanismen bestimmen, wie sich Speech-to-Text live anfühlt:
- Endpointing. Irgendetwas muss entscheiden, ob Sie fertig sind oder nur eine Pause machen. Ist die Schwelle kurz, schneidet Ihnen das System mitten im Gedanken das Wort ab; ist sie lang, endet jeder Satz mit einer unangenehmen Wartezeit. Keine Einstellung passt für alle, deshalb wirken manche Tools ungeduldig und andere träge.
- Zweistufige Dekodierung. Die übliche Architektur kombiniert ein schnelles Modell, das nur bereits Gesprochenes sieht und die flackernden Zwischenergebnisse liefert, mit einem langsameren, das nach vorn schauen kann und die Zeile festschreibt. So gibt es niedrige Latenz, wo es auf Reaktionsschnelligkeit ankommt, und höhere Genauigkeit dort, wo der Text dauerhaft stehen bleibt.
Auch die Latenz ist keine einzelne Zahl. Es gibt die Verzögerung bis zum ersten Wort, die Frequenz, mit der Zwischenergebnisse aktualisiert werden, und die Wartezeit, bis eine Zeile festgeschrieben ist. Die Chunk-Größe beeinflusst vor allem die erste, das Endpointing vor allem die letzte. Ein Anbieter, der nur eine Zahl nennt, nennt die, die ihn gut aussehen lässt.
Wie genau ist Speech-to-Text? Es kommt auf Ihr Audio an
Alle wollen eine Zahl. Die ehrliche Antwort braucht zwei Sätze.
Fachleute messen diese Systeme mit der Wortfehlerrate (Word Error Rate, WER): Alle vertauschten, ausgelassenen oder erfundenen Wörter werden addiert und durch die Zahl der tatsächlich gesprochenen Wörter geteilt. Niedriger ist besser, und die Wortfehlerrate ist das Gegenstück zur Genauigkeit in Prozent, mit der die Werbung arbeitet: 3 % Wortfehlerrate entsprechen 97 % Genauigkeit.
Bei sauberer, gut aufgenommener Sprache einer einzelnen Person liegen führende Engines 2026 grob bei 2–5 %. ElevenLabs' Scribe v2 kam im März 2026 auf etwa 2,3 %; Deepgrams Nova-3 und NVIDIAs Canary Qwen landeten auf unabhängigen englischsprachigen Ranglisten beide bei rund 5 %. Hervorragende Werte – und für die meisten Leser irrelevant.
Benchmarks bestehen aus Aufnahmen, die sich benehmen: vorgelesene Sätze, ordentliche Mikrofone, immer nur eine Stimme. Ihr Audio dagegen ist ein Videocall mit jemandem am Laptoplautsprecher, einem Hund und zwei Leuten, die sich gegenseitig die Sätze vollenden. Über gemischtes Material aus der Praxis streuen veröffentlichte Genauigkeitswerte von etwa 85 % bis 98 %, und für unsauberes Meeting-Audio mit mehreren Sprechern werden meist Fehlerraten zwischen 15 % und 25 % berichtet. Dieselben Engines, eine andere Welt.
Was Ihren Wert beeinflusst, grob nach Schaden sortiert: wie viele Menschen gleichzeitig sprechen, wie weit das Mikrofon vom Mund entfernt ist, wie stark der Raum hallt, wie gut der Akzent der sprechenden Person in den Trainingsdaten vertreten ist und wie speziell das Vokabular ist. Die Lücke bei Akzenten ist real und betrifft die ganze Branche: Jede Engine auf dem Markt, unsere eingeschlossen, verliert an Genauigkeit, wenn Akzente stark sind und Menschen durcheinanderreden. Wer als Anbieter etwas anderes andeutet, will Ihnen etwas verkaufen.
Dazu kommt ein subtileres Problem: Das System merkt nicht, wann es falsch liegt. Es gibt zwar Konfidenzwerte, aber ein flüssiges End-to-End-Modell kann einen grammatisch einwandfreien Satz erzeugen, den niemand gesagt hat, und ihn mit derselben Gelassenheit ausgeben wie einen richtigen. Ein menschlicher Transkriptor schreibt „[unverständlich]“. Ein Modell rät.
Das günstigste Upgrade für mehr Genauigkeit: Ein USB-Mikrofon für 60 $ oder ein kabelgebundenes Headset verbessert Ihre Ergebnisse mehr als ein Anbieterwechsel. Ein Mikrofon nah am Mund dämpft den Raumhall, hebt die Stimme über die Hintergrundgeräusche und erhält die hohen Frequenzen, an denen sich ähnliche Konsonanten unterscheiden. Jedes Modell kämpft mit derselben Physik, und die ist entschieden, bevor die Software überhaupt zum Zug kommt.
Wo Speech-to-Text im Hintergrund arbeitet
Persönliche Produktivität ist nur die sichtbare Spitze. Das große Volumen liegt woanders.
Contact Center sind vermutlich der größte kommerzielle Einsatzbereich. Live-Erkennung speist Assistenzansichten für die Agents, die mitten im Satz die passende Antwort einblenden, und verwandelt die Qualitätssicherung: Statt eine Stichprobe von 2 % der Gespräche anzuhören, wird jeder Anruf bewertet. Routing, Compliance-Prüfungen und Zusammenfassungen nach dem Gespräch basieren alle auf demselben Transkript.
Barrierefreiheit und Untertitel sind der Bereich, in dem die Technik nicht mehr optional ist. In den USA legt die Title-II-Regel des Justizministeriums WCAG 2.1 Stufe AA als Standard für digitale Inhalte von Bundesstaaten und Kommunen fest, mit Fristen im April 2027 und April 2028 je nach Einwohnerzahl, und private Organisationen orientieren sich vielfach an derselben Messlatte. Unabhängig davon verlangt die FCC ab dem 17. August 2026 von Herstellern betroffener Geräte und von Multichannel-Videoanbietern, die Anzeigeeinstellungen für Untertitel leicht zugänglich zu machen. Deutlich gesagt: Automatische Untertitel allein erreichen die Genauigkeit, die diese Regeln voraussetzen, in der Regel nicht. Sie setzen Satzzeichen schlecht, verstümmeln Namen und lassen nichtsprachliche Geräusche weg, die gehörlose Zuschauer brauchen. Regelkonform ist das Muster: maschineller Entwurf plus menschliche Korrektur.
Klinische Dokumentation ist weiterhin ein riesiger Markt. Sobald geschützte Gesundheitsdaten im Spiel sind, braucht es allerdings einen Anbieter, der die entsprechenden Verträge unterschreibt, und keine Allzweck-App. Gerichte nutzen Spracherkennung für einen ersten Durchgang, den zertifizierte Fachkräfte prüfen. Medien und Bildung machen damit Archive durchsuchbar – der eigentliche Gewinn, wenn Sie eine 40-stündige Vorlesungsreihe untertiteln, ist, die vier Minuten über Eigenwerte wiederzufinden.
Und Meetings – dort begegnen die meisten Büroangestellten der Technik heute: Ein System nimmt das Gespräch auf und erstellt ein Transkript mit Zeitstempeln und Sprecherzuordnung. Immer öfter macht es danach auch etwas damit, statt nur eine Textwand zu liefern.
Eingebaut, integriert, spezialisiert oder per API
Jedes Speech-to-Text-Produkt gehört in eine von vier Kategorien, und die Kategorie sagt mehr über Ihre Erfahrung voraus als die Marke.
| Kategorie | Was es ist | Stärken | Wo es endet | Typische Kosten |
|---|---|---|---|---|
| In das Betriebssystem eingebaut | Diktierfunktion von Windows, macOS, iOS und Android | Kostenlos, auf modernen Geräten lokal, keine Einrichtung, funktioniert überall, wo die Tastatur funktioniert | Wenig Formatierung, kein echtes eigenes Vokabular, keine Aufzeichnung | Inklusive |
| In eine App integriert | Spracheingabe in Textverarbeitung, Browser oder Konferenz-Tool | Im Kontext, nichts zu installieren, für diese eine Aufgabe brauchbar | Endet an der App-Grenze; der Text bleibt, wo er entstanden ist | In der App enthalten |
| Spezialisierte Speech-to-Text-Apps | Eigenständige Diktiertastaturen und Meeting-Assistenten | Bereinigt Füllwörter und Zeichensetzung, eigenes Vokabular, app-übergreifend, Zusammenfassungen | Noch ein Abo; meist Cloud, das Audio verlässt also das Gerät | Etwa 10–20 $ pro Nutzer und Monat |
| Entwickler-APIs und offene Modelle | Cloud-Endpunkte für Spracherkennung oder ein selbst gehostetes offenes Modell | Volle Kontrolle, Feinabstimmung, Streaming oder Batch, Mengenpreise | Das Produkt bauen Sie selbst darum herum; ab Werk unbrauchbar | Abrechnung pro Audiostunde oder eigene Rechenleistung |
Spannend wird es in der dritten Kategorie bei der Frage, was nach dem Erkennen der Wörter passiert. Manche Tools hören beim Text auf. Andere behandeln das Transkript als Rohmaterial – Laxis zum Beispiel zeichnet Calls in Zoom, Google Meet und Microsoft Teams in mehr als 100 Sprachen auf, transkribiert sie, zieht Aufgaben heraus und überträgt Ergebnisse nach HubSpot oder Salesforce. Das ist eine andere Aufgabe als schneller tippen. Keiner der Ansätze gewinnt grundsätzlich; sie beantworten unterschiedliche Fragen. Haben Sie bis hierher vor allem gelesen, um ein Produkt auszuwählen: Unser Praxisvergleich der besten Diktier-Tools nennt Namen, was diese Seite bewusst nicht tut.
Was kostet Speech-to-Text? Drei Preismodelle und eine Falle
Die Kosten hängen ganz davon ab, in welcher Kategorie Sie sich bewegen, und die Preismodelle lassen sich nicht direkt vergleichen.
Kostenlos heißt auf Betriebssystemebene tatsächlich kostenlos. Jede große Plattform bringt eine Diktierfunktion mit. Für kurze Einsätze reicht die eingebaute Lösung, und sie läuft zunehmend auf dem Gerät statt auf einem Server.
Abos pro Nutzer sind bei spezialisierten Tools Standard und liegen meist zwischen etwa 10 und 20 $ pro Nutzer und Monat, oft mit einem kostenlosen Kontingent zum Einstieg. Unsere eigenen Preise: der kostenlose Basic-Tarif mit 300 Transkriptionsminuten im Monat, dann 15,99 $ pro Nutzer im Premium-Tarif – genau in diesem Band – und 29,99 $ im Business-Tarif. Entscheidend ist nicht der Listenpreis, sondern Ihr Volumen: Inklusivminuten lohnen sich, sobald Sie mehrere Stunden pro Woche verarbeiten; nutzungsbasierte Abrechnung gewinnt, wenn Sie das Tool zweimal im Monat anfassen.
Nutzungsbasierte API-Preise zeigen die echten Stückkosten, und die Listenpreise von 2026 sind überraschend niedrig. AssemblyAI nennt für asynchrone Transkription etwa 0,15 $ pro Audiostunde mit Universal-2 und 0,21 $ mit Universal-3.5 Pro, Echtzeit-Streaming kostet 0,45 $. Deepgrams Nova-3 liegt bei rund 0,0043 $ pro Minute im Batch und 0,0077 $ im Streaming, also etwa 0,26 $ und 0,46 $ pro Stunde. OpenAIs GPT-4o Transcribe kostet rund 6 $ pro tausend Minuten, die Standardstufe von Google Cloud rund 16 $ pro tausend Minuten vor Mengenrabatten.
Zwei Muster gelten bei allen. Streaming kostet deutlich mehr als die Batch-Verarbeitung desselben Audios – meist 40–50 % mehr –, weil Sie für eine offen gehaltene Verbindung und niedrigere Latenz bezahlen. Und der Listenpreis ist eine Untergrenze, kein Endpreis: Schalten Sie Sprechertrennung, Zusammenfassung, Schwärzung, Stimmungsanalyse und eigenes Vokabular hinzu, können die tatsächlichen Kosten zwei- bis viermal so hoch liegen, wie die Preisseite vermuten lässt. Das ist die Falle.
Speech-to-Text für Ihre Calls nutzen
Laxis zeichnet Meetings in Zoom, Google Meet und Microsoft Teams in mehr als 100 Sprachen auf, transkribiert und fasst sie zusammen, zieht Aufgaben heraus und synchronisiert mit HubSpot und Salesforce. Der kostenlose Basic-Tarif enthält 300 Transkriptionsminuten im Monat.
Was sich geändert hat – und was als Nächstes kommt
Drei Entwicklungen erklären, warum die Technik nicht mehr frustriert und trotzdem weiter besser wird.
Die erste betrifft die Architektur. Handgebaute Pipelines mit getrennten Komponenten für Akustik, Aussprache und Sprache wurden durch einzelne Netze ersetzt, trainiert auf riesigen Archiven gesprochener Sprache samt schriftlicher Fassung. Deshalb wurde die Erkennung von Akzenten, Sprachen und Umgangssprache so viel besser – und deshalb haben sich auch die Fehler verändert. Ältere Systeme lieferten offensichtliches Kauderwelsch, neuere liefern flüssige Fehler im Brustton der Überzeugung.
Die zweite: Die Modelle wurden klein genug, um umzuziehen. Erkennung, die früher ein Rechenzentrum brauchte, läuft heute auf dem Smartphone, und einige Konferenz- und Untertitelfunktionen verarbeiten standardmäßig lokal. Das ist ein echter Gewinn für Datenschutz und Zuverlässigkeit, weil keine Verbindung nötig ist und kein Audio übertragen wird. Bei schwierigem Audio, ungewöhnlichem Vokabular und selteneren Sprachen haben Cloud-Modelle aber weiterhin die Nase vorn – das ist der ehrliche Kompromiss hinter Cloud-Tools wie unserem.
Die dritte ist die Streaming-Architektur. Encoder, die Audio Frame für Frame verarbeiten und bereits Gesehenes zwischenspeichern, statt es neu zu berechnen, haben die Live-Latenz so weit gesenkt, dass sich ein Gespräch mit einer Maschine nicht mehr wie Funkverkehr anfühlt. NVIDIAs Arbeit an cache-fähigen Conformer-Modellen von 2026 ist ein öffentliches Beispiel.
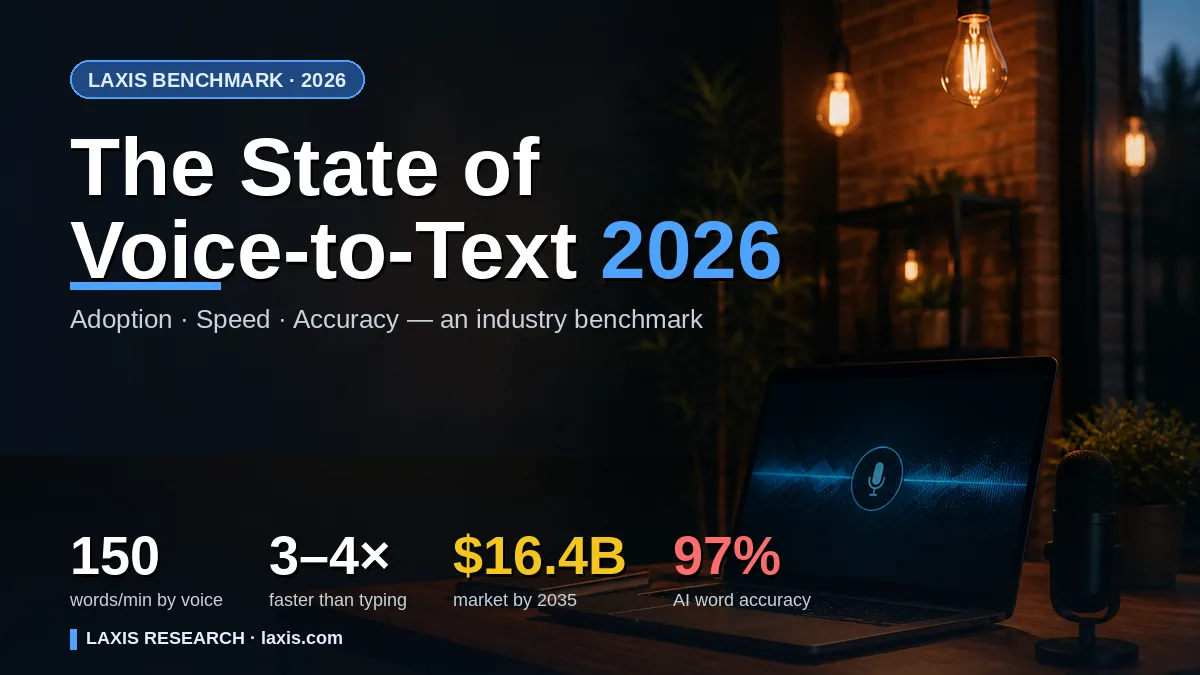
Spannender als ein weiterer Genauigkeitspunkt ist, was als Nächstes kommt. Modelle, die direkt mit Audio arbeiten und eine gesprochene Frage beantworten, ohne je ein Zwischentranskript festzulegen, überspringen den Schritt, den dieser Artikel beschreibt – und stecken bereits in Assistenzprodukten. Auch die Bewertung steht unter Druck: Die Wortfehlerrate wertet ein fehlendes „der“ genauso wie ein fehlendes „nicht“, was offensichtlich falsch ist, und Forschende arbeiten an Maßen, die die Bedeutung gewichten. Die Verbreitungs- und Marktzahlen hinter all dem finden Sie in unserem Bericht zur Lage der Kategorie 2026.
Fazit
Das verbleibende Problem ist nicht das Hören. Bei sauberem Audio ist die Technik ausgereift – genauer als die meisten Menschen, schneller als alle, für den Bruchteil eines Cents pro Minute. Ungelöst sind die menschlichen Teile: zu wissen, wer gesprochen hat, was wichtig war und wann man etwas nicht verstanden hat.
Das Letzte ist die eigentliche Grenze. Ein System, das sagen könnte „Bei dieser Zeile bin ich mir nicht sicher“, wäre mehr wert als eines, das zwei Punkte genauer ist und zu seinen Fehlern schweigt. Bis dahin sollten Sie automatisch erzeugten Text als starken Entwurf eines schnellen, selbstsicheren Kollegen behandeln, der noch nie gefragt hat: „Entschuldigung, können Sie das wiederholen?“
Häufig gestellte Fragen
Was ist Speech-to-Text?
Speech-to-Text ist die Technologie, die gesprochene Sprache in geschriebenen Text umwandelt; der Fachbegriff lautet automatische Spracherkennung. Sie umfasst die Live-Nutzung, bei der die Wörter beim Sprechen auf dem Bildschirm erscheinen, und die nachträgliche Verarbeitung gespeicherter Audio- oder Videodateien. Diktier-Apps, Live-Untertitel, Telefonassistenten und Meeting-Tools sind Produkte, die darauf aufbauen.
Wie funktioniert automatische Spracherkennung?
Ein System zur automatischen Spracherkennung wandelt das Mikrofonsignal zuerst in eine numerische Beschreibung des Klangs um. Dann sucht ein neuronales Netz die Wortfolge, die diesen Klang am wahrscheinlichsten erzeugt hat. Die Suche wägt den akustischen Befund gegen die Plausibilität einer Formulierung ab – deshalb repariert der Kontext Laute, die das Mikrofon schlecht erfasst hat. Formatierung und Sprecherlabels kommen danach hinzu.
Wie genau ist Speech-to-Text?
Bei sauberen Aufnahmen einer einzelnen Person erreichen führende Engines grob 2 bis 5 % Wortfehlerrate, also 95 bis 98 % richtig erkannte Wörter. Veröffentlichte Werte für gemischtes Audio aus der Praxis streuen viel breiter, von etwa 85 bis 98 %, und für unsauberes Meeting-Audio mit mehreren Sprechern werden oft Fehlerraten von 15 bis 25 % berichtet. Ihr Mikrofon und Ihr Raum zählen mehr als Ihr Anbieter.
Was ist der Unterschied zwischen Spracherkennung und Stimmerkennung?
Spracherkennung ermittelt, welche Wörter gesagt wurden. Stimmerkennung im engeren Sinn ermittelt, wer sie gesagt hat, indem sie Stimmmerkmale mit einem hinterlegten Stimmabdruck vergleicht – deshalb nutzen Banken sie, um Anrufer zu verifizieren. Beide laufen als getrennte Systeme und beantworten getrennte Fragen, auch wenn im Alltag „Stimmerkennung“ oft lose für beides verwendet wird.
Ist Speech-to-Text kostenlos?
Ja, in kleinem Umfang. Windows, macOS, iOS und Android bringen eine Diktierfunktion ohne Aufpreis mit, und Browser und Office-Pakete haben ihre eigene Spracheingabe. Kostenpflichtige Tools verlangen entweder einen monatlichen Preis pro Nutzer, meist um die 10 bis 20 US-Dollar, oder rechnen nutzungsbasiert über eine API ab; die Listenpreise 2026 reichen dort von etwa 0,15 bis 1 US-Dollar pro Audiostunde.
Funktioniert Speech-to-Text offline?
Teilweise. Smartphones und Laptops bringen inzwischen komprimierte Erkennungsmodelle mit, die lokal laufen. Einfaches Diktieren und manche Live-Untertitel funktionieren deshalb ohne Verbindung, und kein Audio verlässt das Gerät. Größere Cloud-Modelle sind bei schwierigem Audio, großem Wortschatz und vielen Sprachen meist weiterhin stärker, deshalb verarbeiten die meisten Business-Tools, auch Laxis, in der Cloud.
Was ist der Unterschied zwischen Speech-to-Text und Text-to-Speech?
Sie arbeiten in entgegengesetzte Richtungen. Speech-to-Text hört Audio und erzeugt geschriebenen Text. Text-to-Speech liest geschriebenen Text und erzeugt synthetische Sprache – damit arbeiten Screenreader, Hörbuchvertonungen und die Antworten von Sprachassistenten. Ein Sprachassistent nutzt beides: Spracherkennung, um die Anfrage zu verstehen, und Sprachsynthese, um zu antworten.
Passendes Produkt
Laxis-Sprachtastatur
Diktieren Sie überall mühelos.
- In jeder App diktieren, 4-mal schneller als tippen
- Sauberer, professioneller Text in über 100 Sprachen
- Mac, Windows, iPhone und Android, mit kostenlosem Tarif
Kostenlos starten, keine Kreditkarte erforderlich.
Mehr erfahren ▷