音声認識(Speech to Text)とは?仕組み・精度・費用を解説
スマートフォンに向かって一文を話すと、言葉が次々に画面に表示されます。よく見ると、5語目を言い終えたころに3語目が別の言葉に書き換わることがあります。この小さな揺れに、音声認識という技術の本質が表れています。機械はまず予測を出し、新しい音声という証拠が届くたびに予測を修正しているのです。
音声認識は今やあまりに身近で、その正体を気にする人はほとんどいません。動画に字幕を付け、保険金の請求を処理し、電話の自動音声応答で受け答えをし、診療記録を作り、車のマイクが拾った声も黙々と記録しています。一方で、その失敗は一見でたらめに見えます。しかし仕組みを知ると、ほとんど必然だったことが分かります。
この記事では、音声認識(Speech to Text)という言葉が指す範囲、話してから文字が表示されるまでにシステムが何をしているのか、実際の精度、どんな現場で使われているのか、費用、そして最近の変化を解説します。製品のランキングは扱いません。
音声認識(Speech to Text)とは:リアルタイムとファイルの2つのモード
音声認識(Speech to Text)とは、話した音声を文字に変換する技術です。正式には自動音声認識(ASR:Automatic Speech Recognition)と呼ばれ、2つの言葉はまったく同じものを指します。エンジニアやベンダーは ASR と呼び、一般には「音声認識」「音声テキスト変換」、あるいは英語のまま Speech to Text や Voice to Text と呼ばれています。
よくある誤解は、音声認識を製品カテゴリの1つと考えることです。実際には多くの製品の土台になっている「機能」であり、使い心地がまったく異なる2つのモードがあります。
リアルタイムモードは、音声が届いている最中に処理します。話し手からほんの一瞬遅れて、画面に文字が表示されます。音声入力アプリ、字幕システム、検索バーのマイクボタンがこのモードです。音声を先に保存することはなく、届いたそばから処理していきます。
ファイルモードは、すでにある録音データを処理します。録音全体を一度に参照できるため、ある言葉を確定する前に前後の文脈を確かめられます。会議やインタビューのあとに録音を文字起こしして文書にするときに使うのがこのモードで、関連はあるものの、独自のワークフローを持つ別の作業です。
音声認識と話者認識・音声合成の違い:混同されやすい4つの技術
音声認識について調べると、隣接する3つの技術の情報も混ざって出てきます。どれもまったく別の仕事をする技術なので、ここで一度整理しておきます。
最も紛らわしいのが話者認識(英語の voice recognition)です。英語では広い意味で speech recognition と同じ意味に使われることもありますが、厳密には問題のもう半分、つまり「何を話したか」ではなく「誰が話したか」を扱います。声紋認証のシステムは、話し手の声の物理的な特徴を事前に登録した音声と照合し、本人かどうかを確認します。銀行が「声がパスワードになります」とうたう本人確認がこれです。話者識別や話者分離(ダイアライゼーション)も同じ系統の技術です。分かるのは話した人であって言葉ではなく、しかも音声認識とは独立して動きます。そのため、言葉はすべて正しいのに話者の名前だけが間違っている文字起こしができあがることがあります。
| 技術 | 答える問い | 入力 → 出力 | 身近な例 |
|---|---|---|---|
| 音声認識(ASR、Speech to Text) | 何と話したか? | 音声 → テキスト | 音声入力、字幕、会議の文字起こし、電話の自動音声メニュー |
| 話者認識(声紋認証・話者識別) | 誰が話しているか? | 音声 → 本人の特定、またはラベル | 銀行の音声による本人確認、「話者2」のラベル、科学捜査での声の照合 |
| 音声合成(TTS、Text to Speech) | このテキストをどう読み上げるか? | テキスト → 音声 | スクリーンリーダー、オーディオブック、音声アシスタントの応答、IVR の案内音声 |
| 音声言語理解 | 何を意図していて、何をすべきか? | テキスト(または音声) → 意図と動作 | 「タイマーをセットして」、電話の自動振り分け、オペレーター支援 AI |
音声合成は音声認識をちょうど裏返したもので、声から文字を作るのではなく、文字から声を作ります。音声言語理解は、音声認識の上に乗る技術です。言葉が文字になったあとも、「来週の木曜にずらして」が予定変更の依頼だと判断する仕組みが別に必要です。スマートスピーカーはこの4つのうち3つを1秒足らずでつないで動かしているため、利用者には1つの機能に見えます。
音声認識の仕組み:話している間にシステムがしていること
「コンピューターがひとつひとつの音を辞書の単語と照合している」という直感的なイメージは誤りです。そして、認識結果をよくするために打てる手は、すべてこの誤りの理由から導かれます。
音声認識システムは、言葉を1語ずつ特定しているわけではありません。受け取った音を生み出した可能性が最も高い単語の並びを探し、候補を2つの観点で同時に採点します。音響的な証拠にどれだけ合っているかと、言葉の並びとしてどれだけ自然かです。従来のシステムは、これを別々の部品として持っていました。音を音素に対応づける音響モデル、発音辞書、単語の並びを採点する言語モデルです。現在のエンドツーエンド方式は、この流れ全体を1つのニューラルネットワークとして学習し、テキストのトークンを直接出力します。ただし、根底にある「音と言葉のバランスを取る」計算は同じです。
このバランスで、音声認識の分野で最も有名なジョークも説明できます。英語の「recognize speech(音声を認識する)」と「wreck a nice beach(すてきな浜辺を壊す)」は、音としてはほとんど同じです。どちらかに決められるのは言語側だけで、決め手は「人が実際によく言うのはどちらか」です。日本語で、同じ「きしゃ」から「貴社」「記者」「汽車」を書き分けられるのも、言語側の働きです。この理屈を進めると、誰もが気づくあの動きにたどり着きます。もごもごと発音した言葉を、前後の言葉から答えが明らかなため、システムが正しく補ってしまうのです。
同じ理屈で、最も不満の多い失敗も説明できます。同僚の名字や社内の製品名など、学習データに一度も出てこなかった言葉は、システムには出力できません。「出力しない」のではなく「できない」のです。知っている中で最も近い言葉に置き換えて、そのまま先へ進みます。対策はコンテキストバイアスで、製品によって「カスタム辞書」「カスタム語彙」「単語ブースト」などと呼ばれています。短い用語リストを渡すと、システムはその言葉が選ばれやすくなるよう探索の重みを調整します。多くのツールで最も効果の大きい設定ですが、利用者が最後まで気づかない設定でもあります。
ツールの評価が変わる10分間の設定: 音声認識アプリを評価する前に、カスタム語彙に20語ほど登録してください。チームメンバーの名字、製品名、業界の略語、主要な取引先2社の名前などです。多くの人は使い始めた初日に評価し、名前が3回続けて崩れるのを見て「この技術は使えない」と判断します。実際には技術が悪いのではありません。まだ自社の言葉を知らないだけです。
リアルタイムの音声認識と録音ファイルの処理は別の問題
2つのモードの違いがはっきり出るのはここで、品質をめぐる誤解の多くもここから始まります。完成した録音ファイルを処理するシステムは、先を見ることができます。文の最初を確定する前に、文の終わりまで確認できるのです。これは大きな利点で、聞き分けにくい音でも、3秒先までの文脈があればはるかに判断しやすくなります。同じ音声でも、録音ファイルの処理がリアルタイム処理より一般に精度が高いのはこのためです。製品の品質が違うのではなく、解いている問題の難しさが違います。
リアルタイムのシステムには、参照できる「先」がありません。今すぐ何かを出力しなければならないため、その時点で最も確からしい推測である部分仮説を表示し、音声が届くたびに修正します。画面上で言葉が書き換わっていくのは、この修正です。不具合ではなく、システムが予測を更新しているだけです。
リアルタイム音声認識の使い心地は、主に2つの仕組みで決まります。
- エンドポイント検出: 話し終えたのか、少し間を置いただけなのかを判定する仕組みです。しきい値が短いと話の途中で区切られ、長いと毎回、文の終わりに気まずい待ち時間が生まれます。誰にとっても快適な設定はないため、せっかちに感じるツールと、もたつくツールが出てきます。
- 2段階デコーディング: よくある構成では、まず過去の音声だけを見る高速なモデルが、揺れ動く途中結果を出します。そのあと、先の音声まで見られる低速なモデルが行を確定します。反応の速さが必要な部分では低遅延を、確定して残る部分では高い精度を、と役割を分けています。
遅延も1つの数字では表せません。最初の言葉が表示されるまでの遅れ、途中結果が更新される間隔、行が確定するまでの待ち時間の3つがあります。チャンクサイズ(一度に処理する音声の長さ)は主に1つ目に、エンドポイント検出は主に3つ目に影響します。遅延を1つの数字だけで示すベンダーは、自社に都合のよい数字を選んでいると考えてください。
音声認識の精度は製品ではなく音声で決まる
精度を1つの数字で知りたい人は多いのですが、正確に答えるには2つの文が必要です。
研究者は音声認識システムを単語誤り率(WER)で評価します。置き換わった語、抜け落ちた語、話されていないのに追加された語の数を合計し、実際に話された語数で割った値です。低いほど優秀で、マーケティング資料に出てくる「精度○%」の裏返しにあたります。単語誤り率3%は、精度97%という意味です。
1人の話者をきれいに録音した音声なら、2026年の主要エンジンの単語誤り率はおおむね2〜5%です。ElevenLabs の Scribe v2 は2026年3月の計測で約2.3%、Deepgram の Nova-3 と NVIDIA の Canary Qwen は、第三者による英語のリーダーボードでいずれも5%前後でした。優れた数字ですが、ほとんどの読者にはあまり関係がありません。
理由は、ベンチマークが条件のよい録音で作られていることにあります。原稿の読み上げ、まともなマイク、一度に1人ずつの発話です。一方、実際の音声は、ノートパソコンのスピーカー越しに話す参加者、犬の鳴き声、互いの話を引き取り合う2人が入り混じった Web 会議です。現実のさまざまな音声を対象にした公表値は精度85%から98%まで幅があり、複数の話者が入り乱れる会議の音声では、誤り率15〜25%という報告が一般的です。エンジンは同じでも、音声の世界が違うのです。
精度を左右する要因を、影響の大きい順におおよそ並べると、同時に話す人数、マイクと口の距離、部屋の残響、話し手の訛りが学習データにどれだけ含まれているか、語彙の専門性です。訛りによる精度差は実在し、業界全体の課題です。現在販売されているエンジンは、Laxis も含めて、訛りの強い話し方や発言の重なりで精度が下がります。そうではないと匂わせるベンダーは、売り込みをしているだけです。
さらに厄介な問題もあります。システムは自分の間違いに気づけません。信頼度スコアはあるものの、流暢なエンドツーエンドモデルは、誰も話していない文法的に完璧な文を、正しい文とまったく同じ顔で出力することがあります。人間の文字起こし担当者なら「[聞き取り不能]」と書く箇所を、モデルは推測で埋めてしまうのです。
最も安上がりな精度改善策: ベンダーを乗り換えるより、$60 程度の USB マイクか有線ヘッドセットを使うほうが結果はよくなります。マイクを口元に近づけると部屋の反響が減り、声が背景ノイズより大きく録れ、似た子音を聞き分けるための高い周波数も残ります。どのモデルも同じ物理法則と戦っており、勝負はソフトウェアの出番より前についています。
音声認識の活用分野:コンタクトセンターから会議まで
個人の生産性向上は、目に見える一部にすぎません。利用量の大半は別の分野にあります。
コンタクトセンターは、おそらく最大の商用分野です。リアルタイムの音声認識がオペレーター支援画面に送られ、会話の途中で適切な回答を表示します。品質管理も、全体の2%を抜き取って聞く作業から、すべての通話を採点する作業に変わりました。通話の振り分け、コンプライアンスチェック、通話後の要約も、すべて同じ文字起こしをもとに動いています。
アクセシビリティと字幕は、この技術が欠かせないものになった分野です。米国では司法省の Title II 規則が、州・地方政府のデジタルコンテンツの基準として WCAG 2.1 レベル AA を定めています。遵守期限は人口規模に応じて2027年4月と2028年4月で、民間組織も同じ基準に合わせることが一般的です。これとは別に、2026年8月17日からは FCC(米連邦通信委員会)が、対象機器のメーカーと多チャンネル映像配信事業者に、字幕(クローズドキャプション)の表示設定を簡単に操作できるようにすることを義務づけます。ただし、自動字幕だけでは、これらの規則が前提とする精度に一般に届きません。句読点の扱いが苦手で、人名を崩し、耳の聞こえない視聴者に必要な話し声以外の音も省いてしまいます。規則を満たす現実的な方法は、機械が下書きを作り、人が修正するやり方です。
医療の記録作成も依然として大きな市場です。ただし、保護対象の医療情報(PHI)を扱うなら、汎用アプリではなく、必要な契約を結べるベンダーを選ぶ必要があります。裁判所では、資格を持つ人のレビューを前提とした一次処理として使われています。メディアと教育では、アーカイブを検索できるようにするために使われています。40時間の講義シリーズに字幕を付ける本当の価値は、固有値について話している4分間を探し出せることです。
そして会議です。多くのオフィスワーカーが音声認識に触れるのはここでしょう。システムが通話を記録し、タイムスタンプと話者ラベル付きの文字起こしを作ります。最近は、文字の壁をそのまま渡すのではなく、そのあとの作業まで担うツールが増えています。
音声認識ツールの4分類:OS 標準・アプリ内蔵・専用アプリ・API
音声認識の製品は、すべて次の4つのどれかに分類できます。使い心地はブランドよりも、どの分類に属するかでほぼ決まります。
| 分類 | 概要 | 強み | 限界 | 費用の目安 |
|---|---|---|---|---|
| OS 標準の音声入力 | Windows、macOS、iOS、Android に標準搭載の音声入力 | 無料。最近の端末なら端末内で処理されプライバシー面も安心。設定不要で、キーボードが使える場所ならどこでも使える | 整形は最低限。実用的なカスタム語彙がなく、記録も残らない | OS に含まれる |
| アプリ内蔵の音声入力 | 文書作成ソフト、ブラウザ、Web 会議ツールに組み込まれた音声入力 | 作業中の画面で使え、インストール不要。その用途なら十分に使える | アプリの外では使えず、テキストは作ったアプリに閉じ込められる | アプリの料金に含まれる |
| 音声認識の専用アプリ | 単体の音声入力キーボードや会議アシスタント | フィラー除去と句読点の整形、カスタム語彙、アプリをまたいだ入力、要約 | サブスクリプションが1つ増える。多くはクラウド処理で、音声が端末の外に出る | 1ユーザーあたり月 $10〜$20 程度 |
| 開発者向け API・オープンモデル | クラウドの音声認識 API、または自社でホストするオープンモデル | 完全に制御でき、チューニングも可能。ストリーミングとバッチを選べ、量に応じた料金 | 製品は自分で作る必要があり、そのままでは使えない | 音声1時間ごとの従量課金、または自前の計算資源 |
注目したいのは、3つ目の専用アプリの中にある、文字ができたあとの違いです。テキストを出力して終わるツールもあれば、文字起こしを素材として扱うツールもあります。たとえば Laxis は、Zoom、Google Meet、Microsoft Teams の通話を100以上の言語で録音・文字起こしし、アクションアイテムを抽出して、結果を HubSpot や Salesforce に送ります。これは速く入力することとは別の仕事です。一般論としてどちらが優れているということはなく、答えている問いが違います。どの製品を買うかを決めるためにここまで読んだのであれば、製品名を挙げて比べたAI 音声入力ツールの実機比較をご覧ください。この記事では、あえて製品名による比較はしていません。
音声認識の料金:3つの価格体系と1つの落とし穴
費用はどの分類のツールを使うかで決まり、しかも価格体系の形が違うため、単純には比べられません。
無料:OS に搭載された音声入力は、本当に無料です。主要なプラットフォームにはすべて音声入力が標準で入っており、短い入力なら標準機能で十分です。しかも、サーバーではなく端末上で処理されるケースが増えています。
ユーザー単位のサブスクリプション:専用ツールの標準的な価格体系で、1ユーザーあたり月 $10〜$20 程度に集中しています。多くは無料枠から始められます。Laxis の場合は、無料プランに月300分の文字起こし枠があり、Premium は1ユーザーあたり月額 $15.99 とこの価格帯に収まります(Business は $29.99)。重要なのは表示価格ではなく利用量です。週に数時間分を処理するなら分数込みの定額制が、月に2回しか使わないなら従量課金が有利です。
API の従量課金:音声認識の本当の原価が見えるのはここで、2026年の定価は驚くほど安くなっています。AssemblyAI は非同期の文字起こしを Universal-2 で音声1時間あたり約 $0.15、Universal-3.5 Pro で $0.21、リアルタイムのストリーミングを $0.45 と公表しています。Deepgram の Nova-3 はバッチ処理が1分あたり約 $0.0043、ストリーミングが $0.0077 で、1時間あたりではそれぞれ約 $0.26 と $0.46 です。OpenAI の GPT-4o Transcribe は1,000分あたり約 $6、Google Cloud の標準ティアはボリュームディスカウント前で1,000分あたり約 $16 です。
どのサービスにも共通する傾向が2つあります。1つ目は、同じ音声でもストリーミングはバッチ処理よりはっきり高く、40〜50%増しが一般的なことです。接続を開いたままにすることと、より厳しい遅延の条件に料金を払っているためです。2つ目は、表示価格が価格ではなく最低ラインだということです。話者分離、要約、個人情報のマスキング、感情分析、カスタム語彙をオンにすると、実際のコストは料金ページから想像する額の2〜4倍になることがあります。これが落とし穴です。
会議や商談の音声を Laxis で文字起こし
Laxis は Zoom、Google Meet、Microsoft Teams の会議を100以上の言語で録音・文字起こし・要約し、アクションアイテムを抽出して HubSpot や Salesforce と同期します。無料プランには月300分の文字起こし枠が含まれます。
音声認識技術で変わったこと、これから変わること
音声認識が使いにくいものではなくなり、今も改善を続けている理由は、3つの転換で説明できます。
1つ目はアーキテクチャです。音響・発音・言語の部品を個別に組み合わせたパイプラインは、録音音声とその書き起こしを対にした膨大なデータで学習した単一のネットワークに置き換わりました。訛り、さまざまな言語、くだけた話し言葉への対応が急に改善したのはこのためです。同時に、失敗の仕方も変わりました。昔のシステムは明らかに意味の通らない文字列を出していましたが、今のシステムは自信たっぷりに流暢な誤りを出します。
2つ目は、モデルが端末に載るほど小さくなったことです。かつてデータセンターが必要だった音声認識がスマートフォン上で動き、Web 会議や字幕の機能には、標準で端末内処理するものもあります。通信が不要で音声が外部に送られないため、プライバシーと安定性の面で大きな利点です。ただし、聞き取りにくい音声、珍しい語彙、利用者の少ない言語では、今もクラウドのモデルに分があります。Laxis のようなクラウド型ツールの背景には、このトレードオフがあります。
3つ目はストリーミング向けのアーキテクチャです。音声をフレーム単位で取り込み、処理済みの部分を再計算せずにキャッシュするエンコーダーによって、リアルタイム処理の遅延が大きく縮まりました。機械との会話が、トランシーバーで交互に話すような感覚ではなくなったのです。NVIDIA が2026年に発表したキャッシュ対応 Conformer の研究は、その公開例の1つです。
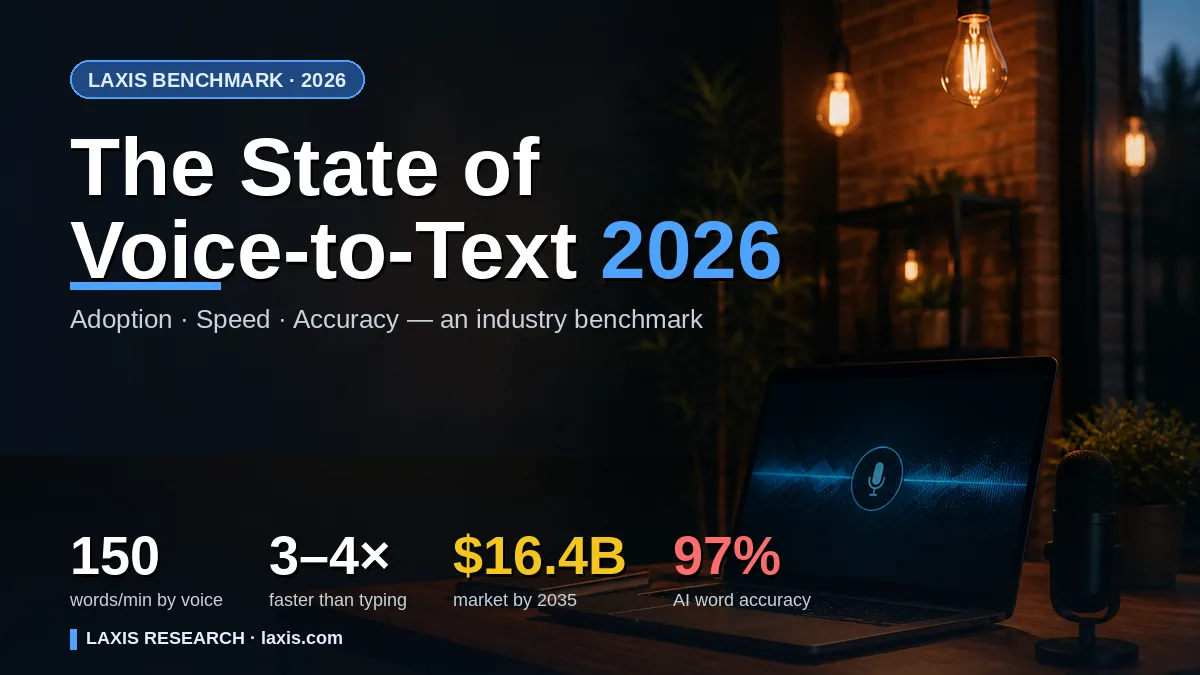
これから起きることは、精度が1ポイント上がる話よりも興味深いものです。音声を直接扱うモデルは、途中で文字起こしを確定させずに、話しかけられた質問に答えます。この記事で説明した工程そのものを飛ばすもので、すでにアシスタント製品に搭載され始めています。評価方法も見直しを迫られています。単語誤り率は、英語の「the」が抜けた場合と「not」が抜けた場合を同じ1語の誤りとして扱います。これは明らかにおかしいため、研究者は意味の重さを反映する指標へ移ろうとしています。こうした変化の裏付けとなる普及率や市場の数字は、2026年の音声テキスト変換の現状レポートにまとめています。
まとめ
残っている課題は「聞き取り」ではありません。きれいな音声に限れば、この技術はすでに完成しています。たいていの人より正確で、誰よりも速く、コストは1分あたり1セントにも届きません。未解決なのは人間的な部分です。誰が話したのか、何が重要だったのか、そして自分が理解できなかったのはどこかを知ることです。
本当の最前線は最後の1つです。「この行は自信がありません」と言えるシステムは、精度が2ポイント高くても自分の誤りに黙っているシステムより価値があります。それが実現するまでは、自動で作られたテキストを、仕事が速く自信家で、「すみません、もう一度お願いできますか」と一度も言ったことのない同僚が書いた、出来のよい下書きとして扱ってください。
よくある質問
音声認識(Speech to Text)とは何ですか?
音声認識とは、話した音声を文字に変換する技術で、正式には自動音声認識(ASR)と呼ばれます。話しながら画面に文字が表示されるリアルタイムの使い方と、保存済みの音声・動画ファイルをあとから処理する使い方の両方を含みます。音声入力アプリ、ライブ字幕、電話の音声アシスタント、会議ツールは、どれもこの技術の上に作られた製品です。
自動音声認識(ASR)はどのような仕組みですか?
自動音声認識は、まずマイクの信号を音の特徴を表す数値に変換し、次にニューラルネットワークがその音を生んだ可能性が最も高い単語の並びを探します。この探索では、音響的な証拠と言葉としての自然さを比べるため、マイクがうまく拾えなかった音も文脈で補えます。句読点などの整形と話者ラベルは、そのあとで付けられます。
音声認識の精度はどのくらいですか?
1人の話者のきれいな録音なら、主要エンジンの単語誤り率はおおむね2〜5%で、95〜98%の語が正しく認識されます。さまざまな実際の音声を対象にした公表値はもっと幅が広く、精度はおよそ85〜98%です。複数の話者が入り乱れる会議の音声では、誤り率15〜25%という報告がよく見られます。精度を左右するのは、ベンダーよりもマイクと部屋の環境です。
音声認識と声紋認証(話者認識)の違いは何ですか?
音声認識は「何と話したか」を割り出す技術で、声紋認証は「誰が話したか」を割り出す技術です。厳密な意味での話者認識は、声の特徴を登録済みの声紋と照合するもので、銀行が電話をかけてきた人の本人確認に使っているのはこちらです。2つは別々のシステムとして動き、別々の問いに答えますが、英語の voice recognition のように、日常的には両方をまとめて指す言い方もよく使われます。
音声認識は無料で使えますか?
小規模な利用なら無料で使えます。Windows、macOS、iOS、Android にはいずれも音声入力が無料で搭載されており、ブラウザやオフィスソフトにも独自の音声入力があります。有料ツールは、月額のユーザー単位課金(一般に $10〜$20 程度)か API の従量課金のどちらかで、2026年の定価は音声1時間あたりおよそ $0.15〜$1 です。
音声認識はオフラインでも使えますか?
一部は使えます。スマートフォンやノートパソコンには端末上で動く軽量な認識モデルが搭載されるようになり、基本的な音声入力や一部のライブ字幕は、通信なしで、音声を端末の外に出さずに動きます。ただし、聞き取りにくい音声、幅広い語彙、多言語では、大規模なクラウドモデルのほうが今も強いのが一般的です。そのため、Laxis を含むほとんどの業務用ツールはクラウドで処理しています。
音声認識と音声合成の違いは何ですか?
処理の向きが逆です。音声認識(Speech to Text)は音声を聞いて文字を作り、音声合成(Text to Speech)は文字を読んで合成音声を作ります。音声合成は、スクリーンリーダー、オーディオブックの朗読、音声アシスタントの応答に使われています。音声アシスタントは両方を使い、依頼を聞き取るときに音声認識を、答えるときに音声合成を使います。
関連製品
Laxis 音声キーボード
どこでも、手間なく音声入力。
- どのアプリでも直接音声入力、タイピングの 4 倍速
- 100 以上の言語で、読みやすくプロフェッショナルな文章に
- Mac・Windows・iPhone・Android 対応、無料プランあり
無料で始められます。クレジットカードは不要です。
詳細を見る ▷