Trascrizione audio: trasformare le registrazioni delle riunioni in testo
Che cos'è la trascrizione audio
La trascrizione audio è il processo che converte il parlato registrato in testo scritto, facendo passare un file audio attraverso un modello di riconoscimento vocale oppure facendolo ascoltare e battere a mano da una persona. Se stai leggendo, probabilmente hai già il file: la chiamata con il cliente di ieri, un memo vocale, un'intervista, la registrazione di un webinar ferma nella cartella dei download. Adesso ti servono le parole.
È un problema diverso dal registrare bene una riunione. La registrazione è già avvenuta, bella o brutta che sia, e non puoi tornare indietro a spostare il microfono. Quello che puoi ancora controllare è il file che dai allo strumento, come gestisci più voci, quanta precisione ti serve e quanta pulizia farai. Queste quattro decisioni fanno la differenza tra qualcosa che un collega legge e un muro di testo che nessuno apre.
Una trascrizione non è un verbale né un riassunto: è la registrazione completa di ciò che è stato detto, intervento dopo intervento. Se vuoi vederne l'anatomia, ecco cosa contiene davvero una trascrizione.
Quali file audio si trascrivono bene e quali falliscono in silenzio
Qui si confondono spesso due cose: il contenitore, cioè l'estensione del file che vedi, e il codec, cioè il modo in cui l'audio è codificato al suo interno. La maggior parte degli strumenti bada a entrambi e ti parla solo del primo.
| Tipo di file | Di solito accettato | A cosa fare attenzione |
|---|---|---|
.wav | Sì | Non compresso, l'input più sicuro. File grandi, quindi una riunione lunga può superare un limite di caricamento. |
.mp3 | Sì | Va bene da bitrate medi in su. Bitrate molto bassi impastano le consonanti. |
.m4a / .aac | Sì | Il formato predefinito dei Memo Vocali dell'iPhone e della maggior parte dei registratori Android. Buona qualità. |
.flac | Di solito | Senza perdita e compatto, ma alcuni strumenti datati non lo decodificano. |
.ogg / .opus | Di solito | Esportazioni di WhatsApp e Discord. Opus regge bene a bitrate bassi. |
.mp4 / .mov | Di solito | Contenitori video. La maggior parte degli strumenti estrae la traccia audio; verifica prima di caricare gigabyte. |
| Audio protetto da DRM | No | I file con gestione dei diritti non si possono decodificare. Procurati una copia non protetta o registra di nuovo. |
| Audio telefonico o di segreteria a 8 kHz | Sì, ma | Si trascrive, con una precisione nettamente peggiore. Vedi sotto. |
La frequenza di campionamento conta più di quanto si pensi. I modelli vocali sono costruiti attorno all'audio a 16 kHz; la documentazione di Whisper di OpenAI prevede di ricampionare l'input a 16 kHz mono. Una registrazione a 44,1 kHz si sottocampiona senza problemi. Una registrazione a 8 kHz invece non si può sovracampionare per recuperare dettagli che non sono mai stati catturati. È questo il vero problema dell'audio telefonico: lo standard di telefonia ITU-T G.711 limita la banda passante a circa 300-3.400 Hz, tagliando l'energia alle alte frequenze che distingue una "s" da una "f" o da un "th". Chi ascolta colma il vuoto con il contesto; i modelli tirano a indovinare, e sbagliano per primi i nomi e i numeri.
Il bitrate è l'altra leva. Un mp3 fortemente compresso butta via i dettagli fini di cui un modello di riconoscimento ha bisogno. Esporta alla qualità più alta offerta dalla sorgente e non ricomprimere. Il mono va benissimo, spesso meglio di un file stereo in cui un canale è quasi muto.
Conta anche da dove arriva il file. Le registrazioni in cloud di solito arrivano come un mp4 più un file separato solo audio, e quello solo audio è il più adatto da caricare. Alcune piattaforme offrono anche tracce separate per partecipante, la cosa migliore che tu possa fare per l'attribuzione dei parlanti. Le trascrizioni delle piattaforme hanno le loro stranezze, e ottenere una trascrizione da Zoom funziona diversamente dal caricare il file grezzo.
Audio con più voci e cosa possono davvero fare le etichette dei parlanti
La diarizzazione dei parlanti è il passaggio che suddivide un flusso audio in chi ha parlato e quando, e poi etichetta gli interventi come Speaker 1, Speaker 2 e così via. Funziona separatamente dal riconoscimento che produce le parole, ed è per questo che una trascrizione può avere un testo corretto ed etichette completamente sbagliate nello stesso momento.
Funziona bene quando le voci sono distinte, le persone parlano a turno e tutti sono vicini a un microfono. Dà il meglio quando ogni parlante ha il proprio canale, perché allora l'attribuzione non è più affatto una deduzione. Ecco dove si inceppa:
- Sovrapposizioni. Quando due persone parlano insieme, il modello deve comunque assegnare quel tratto sovrapposto a una sola etichetta. Alcuni strumenti eliminano del tutto il parlante con la voce più bassa.
- Un solo microfono omnidirezionale in una sala grande. Il riverbero sulle pareti rigide fa arrivare la stessa voce al microfono più volte, con un leggero ritardo. Questo sfuoca la firma acustica su cui si basa la diarizzazione, e le persone più lontane dal microfono finiscono accorpate.
- Interiezioni brevi. "Sì", "giusto" e "mm-hm" sono troppo brevi per essere caratterizzati e vengono assorbiti da chi stava parlando intorno.
- Voci simili. Due persone con un'altezza di voce vicina e lo stesso accento finiscono spesso sotto un'unica etichetta.
- Deriva nel numero di parlanti. La maggior parte degli strumenti stima quante persone sono presenti. Se sottostima, due colleghi condividono un'etichetta; se sovrastima, una persona che si è spostata diventa Speaker 3 e Speaker 5.
Regola le aspettative di conseguenza. In una registrazione pulita di tre o quattro persone, i cambi di turno cadono più o meno dove dovrebbero e passerai qualche minuto ad associare Speaker 1 a un nome. In una registrazione in vivavoce con otto persone, considera le etichette un indizio e verifica sull'audio i momenti che contano: chi si è impegnato sulla data, chi ha sollevato l'obiezione.
Precisione: cosa significano davvero i numeri
Il tasso di errore sulle parole (WER) è la misura standard, e capirlo cambia il modo in cui leggi ogni promessa di precisione di un fornitore. Il WER conta tre tipi di errore rispetto a una trascrizione di riferimento, sostituzioni, cancellazioni e inserimenti, e divide il totale per il numero di parole del riferimento. È la metrica usata dal NIST nelle sue valutazioni di riferimento sul riconoscimento vocale, ed è ciò che di solito significa "precisione del 95%": un tasso di errore del 5%.
Il punto debole è che il WER tratta ogni errore allo stesso modo. Un "um" perso e un "not" perso valgono ciascuno una cancellazione, ma solo il secondo ribalta il senso di una frase. Gli errori che ti costano tempo si concentrano proprio sulle parole a cui tieni di più: nomi, numeri, termini di prodotto, negazioni.
E poi c'è la provenienza del dato. Le precisioni pubblicate si misurano su corpus di riferimento che non somigliano per niente alla tua sala riunioni. LibriSpeech è parlato letto da audiolibri: una persona, un testo scritto, una stanza silenziosa, un microfono vicino. Switchboard sono conversazioni telefoniche tra sconosciuti. Un dato di precisione in evidenza è quasi sempre un risultato su parlato letto e pulito, e la riunione veloce del martedì di nessuno suona come un audiolibro.
Cosa peggiora davvero la precisione, più o meno in ordine di danno:
- Il parlato sovrapposto, il caso più difficile del settore.
- Il riverbero e la distanza dal microfono, che pesano più di quanto la maggior parte delle persone creda.
- L'audio a basso bitrate o a banda stretta, per i motivi di campionamento visti sopra.
- Accenti e dialetti poco rappresentati nei dati di addestramento di un modello. È un limite ben documentato dei sistemi vocali, non un errore di arrotondamento.
- Il gergo di settore, i nomi dei prodotti, le sigle e i cognomi: parole di grande valore che compaiono di rado nei dati di addestramento.
- Il rumore di fondo e i cambi di lingua a metà frase, che i modelli gestiscono male a meno che non siano stati costruiti per farlo.
Prima di lanciare un file di due ore, taglia i primi tre minuti e trascrivi solo quelli. Poi leggili. Se tre minuti richiedono molte correzioni, i restanti 117 ne richiederanno proporzionalmente di più, ed è quello il momento di scegliere tra un passaggio automatico più il tuo tempo di revisione e pagare semplicemente una persona.
La pulizia di cui ha bisogno ogni trascrizione grezza
L'output grezzo di qualsiasi strumento di trascrizione è un ammasso di dati, non un documento. Renderlo leggibile per un collega richiede un passaggio mirato, che va più veloce in quest'ordine.
- Per prima cosa, associa le etichette dei parlanti ai nomi reali. Ogni passaggio successivo diventa più facile quando vedi chi sta parlando, e un trova e sostituisci globale su "Speaker 2" non costa nulla.
- Correggi i nomi propri. È l'errore più prevedibile della trascrizione: il nome della tua azienda, i nomi dei tuoi prodotti, la sigla che il tuo team pronuncia quaranta volte al giorno, il cognome della persona in chiamata. I motori sbagliano in modo costante, storpiando un termine sempre allo stesso modo, quindi un trova e sostituisci per termine di solito sistema tutte le occorrenze. Meglio ancora, previeni il problema: il vocabolario personalizzato ti permette di registrare i termini prima della trascrizione, ed è a questo che serve il dizionario personale (Personal Dictionary) dell'assistente per le riunioni di Laxis.
- Scegli tra trascrizione letterale e versione pulita, poi resta coerente. La trascrizione letterale conserva ogni intercalare, falsa partenza e ripetizione, ed è ciò che serve per la ricerca o per un verbale contestato. La versione pulita li elimina, ed è ciò che serve a qualsiasi testo da leggere. Ma non ripulire troppo: le cautele fanno parte del contenuto. "Penso che probabilmente ce la facciamo entro venerdì" non è lo stesso impegno di "lo facciamo entro venerdì".
- Dividi in paragrafi e punteggia. Vai a capo ai cambi di argomento, non a ogni cambio di parlante, altrimenti uno scambio veloce diventa quaranta paragrafi di una riga.
- Aggiungi i timestamp ai confini delle sezioni così che chiunque possa tornare all'audio.
- Estrai le decisioni e le azioni, con il responsabile indicato. È la parte che le persone usano davvero.
Se preferisci la pratica alla teoria, abbiamo descritto passo per passo l'intero processo per trascrivere l'audio in testo.
Audio in più di una lingua
Se la tua registrazione non è in inglese, o non solo in inglese, due domande decidono tutto: lo strumento rileva la lingua da solo, e la copre davvero come si deve? La copertura varia molto, e il fatto che una lingua compaia in un elenco non significa che venga trascritta bene quanto l'inglese, perché i dati di addestramento sono distribuiti in modo diseguale.
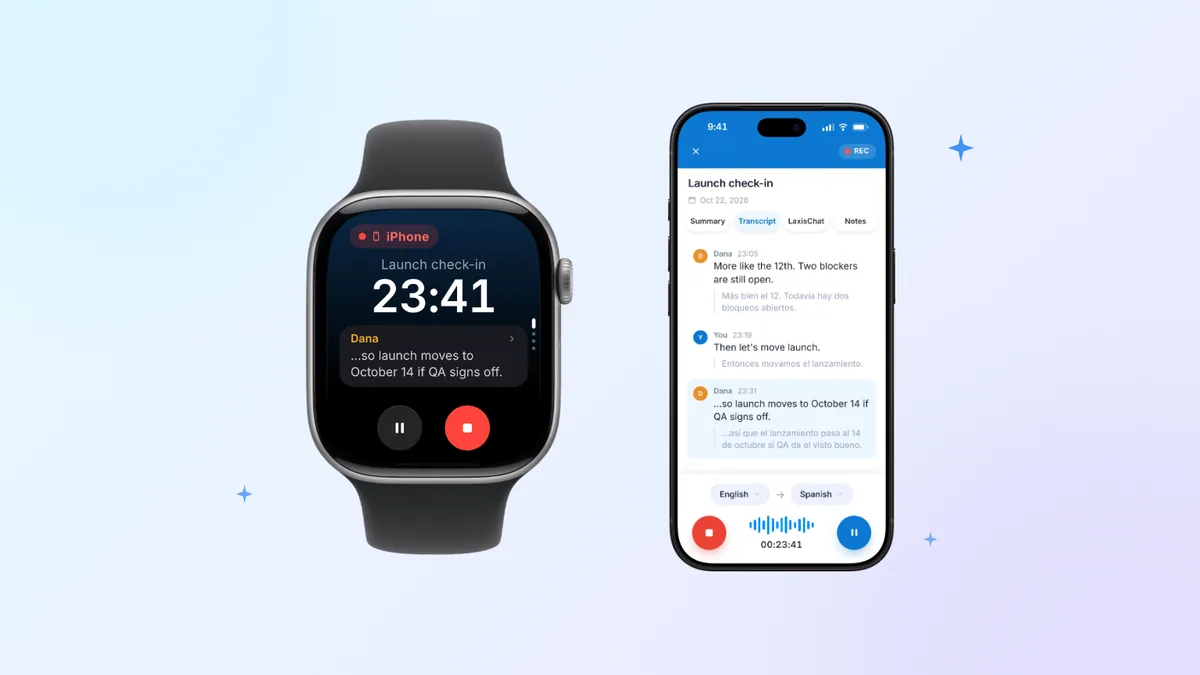
Laxis copre oltre 100 lingue con rilevamento automatico della lingua e, nelle riunioni dal vivo, mostra la traduzione accanto all'originale mentre le persone parlano, con il piano Business che passa automaticamente tra un massimo di cinque lingue all'interno della stessa riunione. Per un file che hai già, procedi nell'ordine giusto: prima rendi corretta la trascrizione, poi traduci. Tradurre una trascrizione piena di errori di riconoscimento produce una traduzione i cui errori nessuno riesce a ricondurre all'originale.
Quanto tempo ci vuole e quanto costa
La trascrizione automatica si completa in una frazione della durata della registrazione, di solito pochi minuti per un'ora di audio, a volte di più se sei in coda dietro altri lavori. La trascrizione umana funziona al contrario: chi trascrive lavora più lentamente del tempo reale, si ferma, torna indietro, controlla l'ortografia, ed è per questo che i tempi di consegna si indicano in ore o giorni e il prezzo si calcola per minuto di audio. L'urgenza costa di più. Chiedi il listino al fornitore specifico invece di affidarti a una cifra generica, perché i prezzi oscillano molto in base a tempi di consegna, qualità dell'audio e numero di parlanti.
Il vincolo in cui ci si imbatte con il software di solito non è il prezzo, ma il limite di durata per singola registrazione, distinto dal pacchetto mensile di minuti. Ecco come funziona su Laxis, che accetta file audio caricati oltre a registrare le riunioni dal vivo:
| Piano | Prezzo | Cosa ottieni |
|---|---|---|
| Free | $0 | 300 minuti di trascrizione al mese, 45 minuti per registrazione |
| Premium | $15.99 per utente al mese, o $9.99 con fatturazione annuale | 2.000 minuti di trascrizione al mese, registrazioni fino a 2 ore |
| Business | $29.99 per utente al mese, o $19.99 con fatturazione annuale | Minuti di trascrizione illimitati, registrazioni fino a 4 ore, più la sincronizzazione con HubSpot e Salesforce |
È il limite per registrazione a cogliere le persone di sorpresa. Una riunione plenaria di tre ore non entra né in Free né in Premium, quindi o dividi il file o passi a un piano superiore. E la sincronizzazione CRM è su Business, non su Premium, cosa che conta se trascrivi le chiamate per inserirle in una pipeline. Laxis funziona su desktop e mobile, si collega a Zoom, Google Meet e Microsoft Teams e offre un'opzione di acquisizione senza bot quando preferisci che nessun partecipante visibile entri nella riunione.
Se stai confrontando strumenti invece di risolvere il problema di un file specifico, il nostro confronto 2026 degli AI note taker mette la categoria fianco a fianco.
Quando pagare invece una persona
Per la maggior parte dell'audio il software è la scelta predefinita giusta. Ci sono casi in cui non lo è, ed essere chiari al riguardo costa meno che scoprirlo a proprie spese.
Atti legali e ufficiali. Deposizioni, procedimenti giudiziari, documenti per le autorità di vigilanza e tutto ciò che potrebbe essere prodotto come prova richiedono di norma una trascrizione certificata da un trascrittore qualificato che ne attesti l'accuratezza. L'output di una macchina non è un atto certificato, per quanto preciso sia.
Audio scadente e molto in gioco. Se la registrazione è un unico microfono lontano in una stanza riverberante con molte sovrapposizioni, e il contenuto conta davvero, le tue ore di revisione costeranno più di un trascrittore. Stima onestamente la pulizia prima di scegliere.
Un accento marcato quando il risultato conta. La qualità del riconoscimento è disomogenea tra accenti e dialetti. Se il modello gestisce male l'accento di chi parla e la trascrizione verrà citata, usata come riferimento o mostrata alla persona stessa, affidati a una persona.
Trascrizione letterale per la ricerca. Nella ricerca qualitativa, in linguistica e in parte del lavoro clinico, le esitazioni, le sovrapposizioni e le autocorrezioni sono i dati, non rumore. Le convenzioni della trascrizione letterale sono precise e le macchine non le applicano.
Audio regolamentato. Verifica la conformità prima di caricare, non dopo. Laxis non è conforme alla HIPAA e non firma BAA, quindi le informazioni sanitarie protette non dovrebbero passarci. Gli altri strumenti prendono impegni diversi; l'unico modo affidabile per saperlo è chiedere al fornitore per iscritto.
C'è un'opzione intermedia che spesso si dimentica: fare prima il passaggio automatico e poi pagare una persona perché revisioni quella bozza invece di trascrivere da zero. Molti servizi la offrono, e costa meno di una trascrizione interamente umana.
Parti dal file che hai già
Se la registrazione è sul tuo desktop in questo momento, caricala, leggi i primi minuti e scopri con cosa hai a che fare prima di decidere quanto impegno merita il resto. Il piano gratuito di Laxis ti offre 300 minuti di trascrizione al mese con un limite di 45 minuti per registrazione, abbastanza per provare la tua registrazione peggiore invece di un file demo curato, e senza un conto alla rovescia di prova mentre lo fai. Provalo con l'assistente per le riunioni di Laxis e giudicalo sul tuo audio, non sul nostro.
Domande frequenti
Che cos'è la trascrizione audio?
La trascrizione audio è la conversione del parlato registrato in testo scritto, svolta da un software di riconoscimento vocale o da un trascrittore umano. L'input è un file audio come un mp3, un m4a o un wav; l'output è testo, di solito con etichette dei parlanti e timestamp. Non è un riassunto.
Quali formati di file audio posso trascrivere?
mp3, m4a, aac e wav funzionano in modo affidabile praticamente con ogni strumento di trascrizione, e di solito anche flac, ogg e opus. I contenitori video come mp4 e mov normalmente funzionano perché lo strumento estrae la traccia audio, ma verificalo prima di caricare un file molto grande. L'audio protetto da DRM non si può trascrivere affatto.
Quanto è precisa la trascrizione audio automatica?
La precisione dipende molto più dalla tua registrazione che dallo strumento che scegli. Dati in evidenza come "precisione del 99%" si misurano su corpus di parlato letto, pulito e con una sola voce, non nelle sale riunioni. Aspettati risultati peggiori con parlanti che si sovrappongono, un microfono lontano, una stanza riverberante, accenti poco familiari o molto gergo. Prova prima tre minuti del tuo audio.
Un software di trascrizione sa distinguere i parlanti?
Sì, tramite la diarizzazione dei parlanti, che segmenta l'audio in base a chi parla ed etichetta gli interventi come Speaker 1, Speaker 2 e così via. È affidabile quando le voci sono distinte e le persone parlano a turno, e poco affidabile con sovrapposizioni, voci simili o un solo microfono omnidirezionale in una sala grande. Dovrai comunque associare tu le etichette ai nomi reali.
Posso trascrivere un file audio che ho già registrato?
Sì. Laxis accetta file audio caricati, quindi una registrazione fatta con il telefono, su una piattaforma per videoconferenze o con un registratore dedicato si può trascrivere senza alcuna riunione dal vivo. Il piano gratuito copre 300 minuti di trascrizione al mese con un limite di 45 minuti per registrazione; Premium porta quel limite a due ore e Business a quattro.
Quando conviene usare la trascrizione umana invece del software?
Affidati a una persona per gli atti legali e ufficiali che richiedono una certificazione, per la trascrizione letterale di ricerca in cui esitazioni e sovrapposizioni sono i dati, e quando un audio scadente e molto in gioco renderebbero il tuo tempo di revisione più costoso di un trascrittore. Una via di mezzo pratica è un passaggio automatico seguito da una persona che revisiona quella bozza.
Prodotto Correlato
Assistente Riunioni Laxis
Automatizza i tuoi appunti oggi.
- Note senza bot per Zoom, Google Meet, Teams e riunioni di persona
- Riepiloghi AI, attività e follow-up in oltre 100 lingue
- Mac, Windows, iPhone e Android, con piano gratuito
Inizia gratis, nessuna carta di credito richiesta.
Scopri di più ▷