Transcrição de áudio: como transformar gravações de reuniões em texto
O que é transcrição de áudio
Transcrição de áudio é o processo de converter a fala gravada em texto escrito, seja rodando um modelo de reconhecimento de voz sobre um arquivo de áudio, seja pedindo a uma pessoa que escute e digite. Se você está lendo isto, provavelmente já tem o arquivo: a ligação com o cliente de ontem, um memorando de voz, uma entrevista, a gravação de um webinar parada na sua pasta de downloads. Agora você precisa das palavras.
Esse é um problema diferente de gravar bem uma reunião. A gravação já aconteceu, boa ou ruim, e não dá para voltar e mudar o microfone de lugar. O que você ainda controla é o arquivo que entrega à ferramenta, como lida com vários falantes, quanta precisão precisa e quanto de limpeza vai fazer. Essas quatro decisões definem se você terá algo que um colega vai ler ou um paredão de texto que ninguém abre.
Uma transcrição não é uma ata nem um resumo: é o registro completo do que foi dito, fala por fala. Se quiser ver a anatomia de uma, veja o que uma transcrição realmente contém.
Quais arquivos de áudio transcrevem bem e quais falham em silêncio
Duas coisas costumam ser confundidas aqui: o contêiner, que é a extensão de arquivo que você vê, e o codec, que é como o áudio está codificado por dentro. A maioria das ferramentas se importa com os dois e só conta a você sobre o primeiro.
| Tipo de arquivo | Costuma ser aceito | O que observar |
|---|---|---|
.wav | Sim | Sem compressão, a entrada mais segura. Arquivos grandes, então uma reunião longa pode passar do limite de upload. |
.mp3 | Sim | Bom a partir de taxas de bits moderadas. Taxas muito baixas borram as consoantes. |
.m4a / .aac | Sim | O padrão do Gravador do iPhone e da maioria dos gravadores Android. Boa qualidade. |
.flac | Geralmente | Sem perdas e compacto, mas algumas ferramentas antigas não o decodificam. |
.ogg / .opus | Geralmente | Exportações do WhatsApp e do Discord. O Opus se sai bem em taxas de bits baixas. |
.mp4 / .mov | Geralmente | Contêineres de vídeo. A maioria das ferramentas extrai a faixa de áudio; confirme antes de enviar gigabytes. |
| Áudio protegido por DRM | Não | Arquivos com gestão de direitos não podem ser decodificados. Consiga uma cópia sem proteção ou grave de novo. |
| Áudio de telefone ou correio de voz a 8 kHz | Sim, mas | Transcreve, com precisão visivelmente pior. Veja abaixo. |
A taxa de amostragem importa mais do que as pessoas imaginam. Os modelos de voz são construídos em torno de áudio de 16 kHz; a documentação do Whisper, da OpenAI, especifica reamostrar a entrada para 16 kHz mono. Uma gravação de 44,1 kHz é reduzida sem problema. Uma gravação de 8 kHz não pode ser ampliada para recuperar detalhes que nunca foram captados. Esse é o verdadeiro problema do áudio de telefone: o padrão de telefonia ITU-T G.711 limita a banda de passagem a cerca de 300 a 3.400 Hz, cortando a energia de alta frequência que distingue um "s" de um "f" ou de um "th". Ouvintes humanos preenchem a lacuna pelo contexto; os modelos chutam, e erram primeiro nos nomes e nos números.
A taxa de bits é a outra alavanca. Um mp3 muito comprimido descarta o detalhe fino de que um modelo de reconhecimento precisa. Exporte na maior qualidade que a fonte oferecer e não comprima de novo. Mono está ótimo, muitas vezes melhor do que um arquivo estéreo em que um dos canais está quase mudo.
A origem do arquivo também conta. Gravações na nuvem costumam chegar como um mp4 mais um arquivo separado só de áudio, e o arquivo só de áudio é o melhor para enviar. Algumas plataformas também oferecem faixas por participante, a melhor coisa que você pode fazer pela atribuição dos falantes. As transcrições das próprias plataformas têm suas manias, e tirar uma transcrição do Zoom funciona de um jeito diferente de enviar o arquivo bruto.
Áudio com vários falantes e o que os rótulos de falante realmente conseguem fazer
A diarização de falantes é a etapa que divide um fluxo de áudio em quem falou quando e depois rotula as falas como Speaker 1, Speaker 2 e assim por diante. Ela roda separada do reconhecimento que produz as palavras, e é por isso que uma transcrição pode ter o texto certo e rótulos muito errados ao mesmo tempo.
Ela funciona bem quando as vozes são distintas, as pessoas se revezam e todos estão perto de um microfone. Funciona melhor ainda quando cada falante está em seu próprio canal, porque aí a atribuição deixa de ser uma inferência. Onde ela falha:
- Falas sobrepostas. Quando duas pessoas falam ao mesmo tempo, o modelo ainda precisa atribuir esse trecho a um único rótulo. Algumas ferramentas descartam por completo o falante mais baixo.
- Um único microfone omnidirecional em uma sala grande. A reverberação em paredes duras faz a mesma voz chegar ao microfone várias vezes, com um leve atraso. Isso borra a assinatura acústica da qual a diarização depende, e as pessoas mais distantes do microfone acabam fundidas.
- Interjeições curtas. "Sim", "certo" e "hum-hum" são curtas demais para serem caracterizadas e acabam absorvidas por quem estava falando ao redor.
- Vozes parecidas. Duas pessoas com tom de voz próximo e o mesmo sotaque são frequentemente juntadas em um só rótulo.
- Desvio na contagem de falantes. A maioria das ferramentas estima quantas pessoas estão presentes. Se estimar para menos, dois colegas dividem um rótulo; se estimar para mais, uma pessoa que se mexeu vira Speaker 3 e Speaker 5.
Ajuste as expectativas de acordo. Em uma gravação limpa de três ou quatro pessoas, as trocas de fala caem mais ou menos onde deveriam e você vai gastar alguns minutos associando Speaker 1 a um nome. Em uma gravação de viva-voz com oito pessoas, trate os rótulos como uma pista e confira no áudio os momentos que importam: quem se comprometeu com a data, quem levantou a objeção.
Precisão: o que os números realmente significam
A taxa de erro de palavras (WER) é a medida padrão, e entendê-la muda a forma como você lê qualquer promessa de precisão de um fornecedor. A WER conta três tipos de erro em relação a uma transcrição de referência, substituições, omissões e inserções, e divide o total pelo número de palavras da referência. É a métrica que o NIST usou em suas avaliações de referência de reconhecimento de fala, e é o que "95% de precisão" normalmente quer dizer: uma taxa de erro de 5%.
O problema é que a WER trata todo erro como igual. Um "um" perdido e um "not" perdido contam como uma omissão cada, mas só o segundo inverte o sentido de uma frase. Os erros que custam o seu tempo se concentram nas palavras que mais importam: nomes, números, termos de produto, negações.
E ainda tem a origem do número. As precisões divulgadas são medidas em corpora de referência, e esses corpora não se parecem em nada com a sua sala de reunião. O LibriSpeech é fala lida de audiolivros: uma pessoa, com roteiro, sala silenciosa, microfone perto. O Switchboard são conversas telefônicas entre desconhecidos. Um número de precisão em destaque é quase sempre um resultado de fala lida e limpa, e a reunião rápida de terça-feira de ninguém soa como um audiolivro.
O que de fato piora a precisão, mais ou menos em ordem de estrago:
- Fala sobreposta, o caso mais difícil da área.
- Reverberação e distância do microfone, que prejudicam mais do que a maioria imagina.
- Áudio de baixa taxa de bits ou de banda estreita, pelos motivos de amostragem vistos acima.
- Sotaques e dialetos pouco representados nos dados de treinamento de um modelo. É uma limitação bem documentada dos sistemas de voz, não um erro de arredondamento.
- Jargão do setor, nomes de produtos, siglas e sobrenomes: palavras valiosas que aparecem pouco nos dados de treinamento.
- Ruído de fundo e troca de idioma no meio da frase, que os modelos tratam mal a não ser que tenham sido feitos para isso.
Antes de mandar um arquivo de duas horas, corte os três primeiros minutos e transcreva só esse trecho. Depois leia. Se três minutos precisam de muita edição, os 117 restantes vão precisar proporcionalmente de mais, e é nesse momento que você escolhe entre uma passada automática somada ao seu próprio tempo de edição e simplesmente pagar uma pessoa.
A limpeza que toda transcrição bruta precisa
A saída bruta de qualquer ferramenta de transcrição é um despejo de dados, não um documento. Deixá-la pronta para um colega ler exige uma passada deliberada, e ela vai mais rápido nesta ordem.
- Primeiro, associe os rótulos de falante a nomes reais. Todas as etapas seguintes ficam mais fáceis quando você vê quem está falando, e um localizar e substituir global em "Speaker 2" não custa nada.
- Corrija os nomes próprios. É a falha mais previsível da transcrição: o nome da sua empresa, os nomes dos seus produtos, a sigla que sua equipe fala quarenta vezes por dia, o sobrenome da pessoa na ligação. Os motores erram de forma consistente, deturpando um termo sempre do mesmo jeito, então um localizar e substituir por termo costuma resolver todas as ocorrências. Melhor ainda é prevenir: o vocabulário personalizado permite registrar termos antes da transcrição, e é para isso que serve o dicionário pessoal (Personal Dictionary) do assistente de reuniões Laxis.
- Escolha entre literal ou versão limpa e mantenha a escolha. A transcrição literal preserva cada vício de linguagem, começo em falso e repetição, o que você quer para pesquisa ou para um registro contestado. A versão limpa remove tudo isso, que é o que qualquer texto para leitura precisa. Mas não limpe demais: as ressalvas são conteúdo. "Acho que provavelmente dá para fazer até sexta" não é o mesmo compromisso que "vamos fazer até sexta".
- Divida em parágrafos e pontue. Quebre nas mudanças de assunto, não a cada troca de falante, ou uma troca rápida vira quarenta parágrafos de uma linha.
- Adicione marcações de tempo nos limites das seções para que qualquer pessoa possa voltar ao áudio.
- Extraia as decisões e as tarefas com os responsáveis. É a parte que as pessoas realmente usam.
Se você quer o passo a passo em vez da teoria, escrevemos todo o processo de transcrever áudio em texto em detalhes.
Áudio em mais de um idioma
Se a sua gravação não está em inglês, ou não só em inglês, duas perguntas decidem tudo: a ferramenta detecta o idioma sozinha, e ela cobre esse idioma de verdade? A cobertura varia muito, e um idioma aparecer em uma lista de suporte não significa que ele é transcrito tão bem quanto o inglês, porque os dados de treinamento são distribuídos de forma desigual.
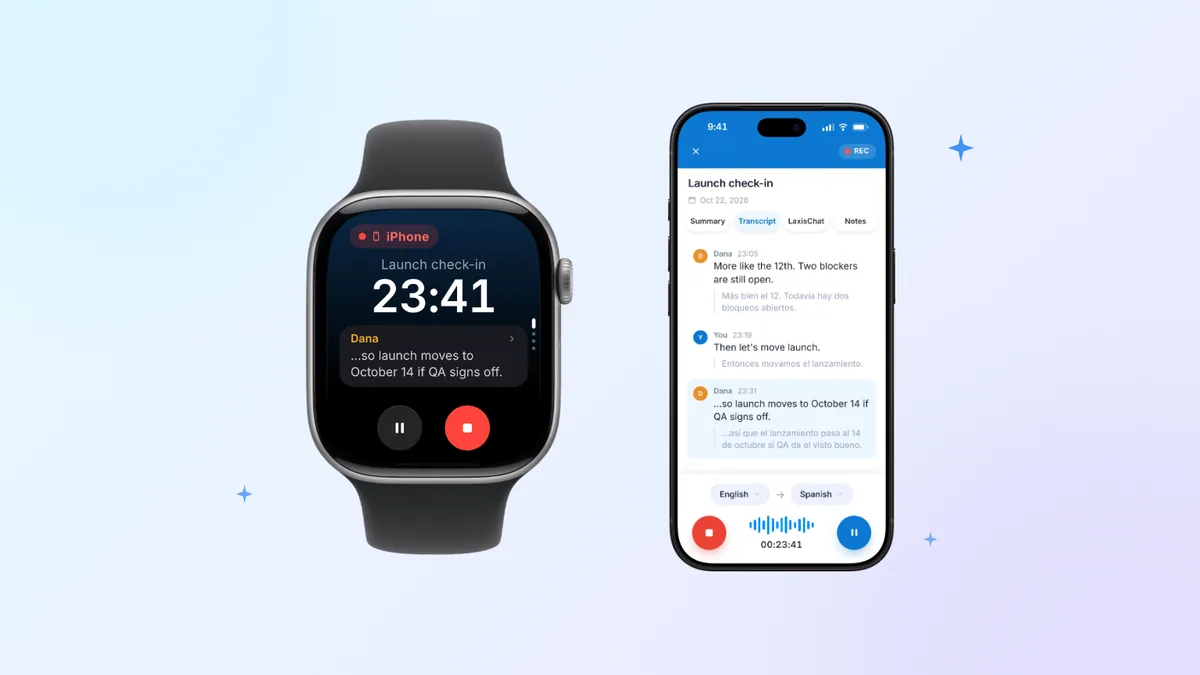
O Laxis cobre mais de 100 idiomas com detecção automática de idioma e, em reuniões ao vivo, mostra a tradução lado a lado enquanto as pessoas falam, com o plano Business alternando automaticamente entre até cinco idiomas em uma mesma reunião. Para um arquivo que você já tem, siga a ordem certa: primeiro acerte a transcrição, depois traduza. Traduzir uma transcrição cheia de erros de reconhecimento gera uma tradução cujos erros ninguém consegue rastrear até a origem.
Quanto tempo leva e quanto custa
A transcrição automática termina em uma fração da duração da gravação, normalmente minutos para uma hora de áudio, às vezes mais se você estiver na fila atrás de outros trabalhos. A transcrição humana funciona ao contrário: o transcritor trabalha mais devagar que o tempo real, parando, voltando e conferindo a grafia, e é por isso que os prazos são dados em horas ou dias e o preço é cobrado por minuto de áudio. Urgência custa mais. Peça a tabela de preços do fornecedor específico em vez de confiar em um número genérico, porque os preços variam muito conforme o prazo, a qualidade do áudio e o número de falantes.
A limitação que as pessoas encontram com software normalmente não é o preço, e sim o limite de duração por gravação, separado da cota mensal de minutos. Veja como isso funciona no Laxis, que aceita arquivos de áudio enviados além de capturar reuniões ao vivo:
| Plano | Preço | O que você recebe |
|---|---|---|
| Free | $0 | 300 minutos de transcrição por mês, 45 minutos por gravação |
| Premium | $15,99 por usuário/mês, ou $9,99 no plano anual | 2.000 minutos de transcrição por mês, gravações de até 2 horas |
| Business | $29,99 por usuário/mês, ou $19,99 no plano anual | Minutos de transcrição ilimitados, gravações de até 4 horas, além de sincronização com HubSpot e Salesforce |
O limite por gravação é o que pega as pessoas de surpresa. Uma reunião geral de três horas não cabe no Free nem no Premium, então você divide o arquivo ou sobe de plano. E a sincronização com CRM fica no Business, não no Premium, o que importa se você transcreve ligações para colocá-las em um pipeline. O Laxis roda no desktop e no celular, se conecta ao Zoom, ao Google Meet e ao Microsoft Teams e oferece uma opção de captura sem bot quando você prefere que nenhum participante visível entre na reunião.
Se você está comparando ferramentas em vez de resolver o problema de um arquivo específico, nosso comparativo 2026 de anotadores com IA coloca a categoria lado a lado.
Quando pagar uma pessoa
Software é a escolha padrão certa para a maior parte dos áudios. Há casos em que não é, e ser franco sobre eles sai mais barato do que descobrir do jeito difícil.
Registros jurídicos e oficiais. Depoimentos, processos judiciais, documentos regulatórios e qualquer coisa que possa ser apresentada como prova geralmente exigem uma transcrição certificada por um transcritor qualificado que ateste sua exatidão. A saída de uma máquina não é um registro certificado, por mais precisa que seja.
Áudio ruim e muito em jogo. Se a gravação vem de um único microfone distante em uma sala com eco e muita fala sobreposta, e o conteúdo realmente importa, suas horas de edição vão custar mais do que um transcritor. Estime a limpeza com honestidade antes de escolher.
Um sotaque forte quando o resultado importa. A qualidade do reconhecimento é desigual entre sotaques e dialetos. Se o modelo lida mal com o sotaque do falante e a transcrição vai ser citada, usada como base ou mostrada ao próprio falante, recorra a uma pessoa.
Transcrição literal para pesquisa. Em pesquisa qualitativa, linguística e parte do trabalho clínico, as hesitações, as sobreposições e as autocorreções são os dados, não ruído. As convenções da transcrição literal são específicas e as máquinas não as aplicam.
Áudio regulado. Verifique a conformidade antes de enviar, não depois. O Laxis não é compatível com a HIPAA e não assina BAAs, então informações de saúde protegidas não devem passar por ele. Outras ferramentas assumem compromissos diferentes; a única forma confiável de saber é perguntar ao fornecedor por escrito.
Existe uma opção intermediária que as pessoas esquecem: fazer primeiro a passada automática e depois pagar uma pessoa para editar esse rascunho, em vez de transcrever do zero. Muitos serviços oferecem isso, e custa menos do que a transcrição totalmente humana.
Comece pelo arquivo que você já tem
Se a gravação está agora mesmo na sua área de trabalho, envie-a, leia os primeiros minutos e descubra com o que você está lidando antes de decidir quanto esforço o resto merece. O plano gratuito do Laxis oferece 300 minutos de transcrição por mês com limite de 45 minutos por gravação, o suficiente para testar a sua pior gravação em vez de um arquivo de demonstração caprichado, e sem um relógio de teste correndo enquanto isso. Experimente com o assistente de reuniões Laxis e julgue pelo seu áudio, não pelo nosso.
Perguntas frequentes
O que é transcrição de áudio?
Transcrição de áudio é a conversão da fala gravada em texto escrito, feita por um software de reconhecimento de voz ou por um transcritor humano. A entrada é um arquivo de áudio como mp3, m4a ou wav; a saída é texto, geralmente com rótulos de falante e marcações de tempo. Não é um resumo.
Quais formatos de arquivo de áudio posso transcrever?
mp3, m4a, aac e wav funcionam de forma confiável em praticamente todas as ferramentas de transcrição, e flac, ogg e opus geralmente também. Contêineres de vídeo como mp4 e mov normalmente funcionam porque a ferramenta extrai a faixa de áudio, mas confirme antes de enviar um arquivo muito grande. Áudio protegido por DRM não pode ser transcrito de jeito nenhum.
Qual é a precisão da transcrição automática de áudio?
A precisão depende muito mais da sua gravação do que da ferramenta escolhida. Números em destaque como "99% de precisão" são medidos em corpora de fala lida, limpa e de um único falante, não em salas de reunião. Espere resultados piores com falantes que se sobrepõem, microfone distante, sala com eco, sotaques pouco comuns ou muito jargão. Teste primeiro três minutos do seu próprio áudio.
O software de transcrição consegue distinguir os falantes?
Sim, por meio da diarização de falantes, que segmenta o áudio conforme quem está falando e rotula as falas como Speaker 1, Speaker 2 e assim por diante. É confiável quando as vozes são distintas e as pessoas se revezam, e pouco confiável com falas sobrepostas, vozes parecidas ou um único microfone omnidirecional em uma sala grande. Você ainda vai precisar associar os rótulos aos nomes reais.
Posso transcrever um arquivo de áudio que já gravei?
Sim. O Laxis aceita arquivos de áudio enviados, então uma gravação feita no celular, em uma plataforma de videoconferência ou em um gravador dedicado pode ser transcrita sem nenhuma reunião ao vivo. O plano gratuito cobre 300 minutos de transcrição por mês com limite de 45 minutos por gravação; o Premium eleva esse limite para duas horas e o Business para quatro.
Quando devo usar transcrição humana em vez de software?
Use uma pessoa para registros jurídicos e oficiais que precisam de certificação, para transcrição literal de pesquisa em que hesitações e sobreposições são os dados, e quando um áudio ruim somado a muito em jogo faria seu tempo de edição custar mais do que um transcritor. Um meio-termo prático é uma passada automática seguida de uma pessoa editando esse rascunho.
Produto Relacionado
Assistente de Reuniões Laxis
Automatize suas anotações hoje.
- Notas sem bot para Zoom, Google Meet, Teams e reuniões presenciais
- Resumos com IA, tarefas e follow-ups em mais de 100 idiomas
- Mac, Windows, iPhone e Android, com plano gratuito
Comece gratuitamente, sem necessidade de cartão de crédito.
Saiba Mais ▷