Audiodatei transkribieren: Aus Meeting-Aufnahmen wird Text
Was ist Audio-Transkription?
Audio-Transkription heißt, aufgezeichnete Sprache in geschriebenen Text umzuwandeln: Entweder läuft ein Spracherkennungsmodell über die Audiodatei, oder ein Mensch hört zu und tippt mit. Wenn Sie das hier lesen, haben Sie die Datei vermutlich schon: das Kundengespräch von gestern, eine Sprachnotiz, ein Interview, einen Webinar-Export in Ihrem Download-Ordner. Jetzt brauchen Sie den Text.
Das ist eine andere Aufgabe, als ein Meeting gut aufzuzeichnen. Die Aufnahme ist gemacht, ob gut oder schlecht, und das Mikrofon lässt sich nachträglich nicht mehr umstellen. Beeinflussen können Sie noch, welche Datei Sie dem Tool geben, wie Sie mit mehreren Sprechern umgehen, wie viel Genauigkeit Sie brauchen und wie viel Nacharbeit Sie investieren. Diese vier Entscheidungen bestimmen, ob am Ende etwas steht, das eine Kollegin liest, oder eine Textwand, die niemand öffnet.
Ein Transkript ist weder Meeting-Notiz noch Zusammenfassung, sondern die vollständige Aufzeichnung des Gesagten, Redebeitrag für Redebeitrag. Wie eines aufgebaut ist, lesen Sie in unserem Beitrag darüber, was ein Transkript tatsächlich enthält.
Welche Audiodateien sich gut transkribieren lassen und welche unbemerkt scheitern
Hier werden gern zwei Dinge verwechselt: der Container, also die Dateiendung, die Sie sehen, und der Codec, also die Art, wie das Audio darin kodiert ist. Die meisten Tools achten auf beides, nennen Ihnen aber nur das Erste.
| Dateityp | Meist akzeptiert | Worauf Sie achten sollten |
|---|---|---|
.wav | Ja | Unkomprimiert und damit die sicherste Eingabe. Die Dateien sind groß, ein langes Meeting kann ein Upload-Limit sprengen. |
.mp3 | Ja | Ab mittleren Bitraten gut. Sehr niedrige Bitraten verwaschen Konsonanten. |
.m4a / .aac | Ja | Standard bei iPhone-Sprachmemos und den meisten Android-Aufnahme-Apps. Gute Qualität. |
.flac | Meistens | Verlustfrei und kompakt, manche ältere Tools können es aber nicht dekodieren. |
.ogg / .opus | Meistens | Exporte aus WhatsApp und Discord. Opus hält auch bei niedrigen Bitraten gut mit. |
.mp4 / .mov | Meistens | Video-Container. Die meisten Tools extrahieren die Tonspur; prüfen Sie das, bevor Sie Gigabytes hochladen. |
| DRM-geschütztes Audio | Nein | Rechtegeschützte Dateien lassen sich nicht dekodieren. Besorgen Sie eine ungeschützte Kopie oder nehmen Sie neu auf. |
| Telefon- oder Mailbox-Audio mit 8 kHz | Ja, aber | Wird transkribiert, allerdings mit spürbar schlechterer Genauigkeit. Siehe unten. |
Die Abtastrate zählt mehr, als man denkt. Sprachmodelle sind auf 16-kHz-Audio ausgelegt; die Dokumentation zu OpenAIs Whisper sieht vor, die Eingabe auf 16 kHz mono umzurechnen. Eine Aufnahme mit 44,1 kHz lässt sich problemlos herunterrechnen. Eine 8-kHz-Aufnahme dagegen lässt sich nicht hochrechnen: Details, die nie aufgezeichnet wurden, kommen nicht zurück. Genau das ist das Problem bei Telefonaudio. Der Telefoniestandard G.711 der ITU-T begrenzt das Übertragungsband auf etwa 300 bis 3.400 Hz und schneidet damit die hohen Frequenzen ab, die ein „s“ von einem „f“ oder ein „sch“ von einem „ch“ unterscheiden. Menschen ergänzen die Lücke aus dem Kontext. Modelle raten, und sie raten zuerst bei Namen und Zahlen falsch.
Der zweite Hebel ist die Bitrate. Eine stark komprimierte mp3 verwirft genau die feinen Details, die ein Erkennungsmodell braucht. Exportieren Sie in der höchsten Qualität, die die Quelle hergibt, und komprimieren Sie nicht erneut. Mono ist in Ordnung und oft besser als eine Stereodatei, bei der ein Kanal fast stumm ist.
Auch die Herkunft der Datei spielt eine Rolle. Cloud-Aufnahmen kommen meist als mp4 plus separate reine Audiodatei, und die reine Audiodatei ist der bessere Upload. Manche Plattformen bieten zudem getrennte Spuren pro Teilnehmer an – das Beste, was Sie für die Sprecherzuordnung tun können. Plattform-Transkripte haben ihre eigenen Tücken, und ein Transkript aus Zoom zu holen funktioniert anders, als die Rohdatei hochzuladen.
Mehrere Sprecher: Was die Sprechererkennung wirklich leistet
Die Sprechererkennung (Diarisierung) zerlegt einen Audiostrom danach, wer wann gesprochen hat, und benennt die Redebeiträge als Sprecher 1, Sprecher 2 und so weiter. Sie läuft getrennt von der Spracherkennung, die die Wörter liefert. Deshalb kann ein Transkript gleichzeitig einen korrekten Text und völlig falsche Sprecherzuordnungen haben.
Gut funktioniert sie, wenn sich die Stimmen deutlich unterscheiden, die Beteiligten nacheinander sprechen und alle nah am Mikrofon sitzen. Am besten, wenn jeder Sprecher auf einem eigenen Kanal liegt, denn dann muss die Zuordnung gar nicht erst erschlossen werden. Hier stößt sie an Grenzen:
- Durcheinanderreden. Sprechen zwei Personen gleichzeitig, muss das Modell den überlappenden Abschnitt trotzdem einer einzigen Bezeichnung zuordnen. Manche Tools lassen die leisere Stimme ganz weg.
- Ein Kugelmikrofon in einem großen Raum. Durch den Hall an harten Wänden erreicht dieselbe Stimme das Mikrofon mehrmals, leicht verzögert. Das verwischt die akustische Signatur, auf die sich die Sprechererkennung stützt, und die Personen, die am weitesten vom Mikrofon entfernt sitzen, werden zusammengelegt.
- Kurze Einwürfe. „Ja“, „genau“ und „mhm“ sind zu kurz, um sie einer Stimme zuzuordnen, und werden dem zugeschlagen, der gerade drumherum spricht.
- Ähnliche Stimmen. Zwei Personen mit ähnlicher Stimmlage und demselben Akzent landen regelmäßig unter einer Bezeichnung.
- Falsch geschätzte Sprecherzahl. Die meisten Tools schätzen, wie viele Personen anwesend sind. Schätzen sie zu niedrig, teilen sich zwei Kollegen eine Bezeichnung; schätzen sie zu hoch, wird eine Person, die sich im Raum bewegt hat, zu Sprecher 3 und Sprecher 5.
Passen Sie Ihre Erwartungen entsprechend an. Bei einer sauberen Aufnahme mit drei oder vier Personen liegen die Sprecherwechsel ungefähr dort, wo sie hingehören, und Sie brauchen ein paar Minuten, um Sprecher 1 einem Namen zuzuordnen. Bei einer Freisprech-Aufnahme mit acht Personen sind die Bezeichnungen nur ein Anhaltspunkt: Prüfen Sie die entscheidenden Momente im Audio nach, etwa wer den Termin zugesagt und wer den Einwand vorgebracht hat.
Wie genau ist Transkription? Was die Zahlen wirklich bedeuten
Das Standardmaß ist die Wortfehlerrate (Word Error Rate, WER). Wer sie versteht, liest jede Genauigkeitsangabe eines Anbieters mit anderen Augen. Die WER zählt drei Arten von Fehlern gegenüber einem Referenztranskript – Ersetzungen, Auslassungen und Einfügungen – und teilt die Summe durch die Zahl der Wörter in der Referenz. Diese Kennzahl hat das NIST in seinen Benchmark-Evaluierungen zur Spracherkennung verwendet, und sie ist gemeint, wenn von „95 % Genauigkeit“ die Rede ist: eine Wortfehlerrate von 5 %.
Der Haken: Die WER gewichtet jeden Fehler gleich. Ein ausgelassenes „äh“ und ein ausgelassenes „nicht“ sind jeweils eine Auslassung, aber nur das „nicht“ dreht die Bedeutung eines Satzes um. Die Fehler, die Sie Zeit kosten, häufen sich bei den Wörtern, auf die es Ihnen am meisten ankommt: Namen, Zahlen, Produktbegriffe, Verneinungen.
Dazu kommt die Frage, woher die Zahl stammt. Veröffentlichte Genauigkeitswerte werden auf Benchmark-Korpora gemessen, und die haben mit Ihrem Besprechungsraum nichts gemein. LibriSpeech besteht aus vorgelesenen Hörbüchern: eine Person, ein fester Text, ein ruhiger Raum, ein Mikrofon direkt vor dem Mund. Switchboard enthält Telefongespräche zwischen Fremden. Eine groß beworbene Genauigkeitszahl stammt fast immer aus sauber vorgelesener Sprache, und kein Standup am Dienstag klingt wie ein Hörbuch.
Was die Genauigkeit tatsächlich senkt, grob nach Schaden geordnet:
- Überlappende Sprache, der schwierigste Fall des ganzen Fachgebiets.
- Hall und Abstand zum Mikrofon, die mehr schaden, als die meisten annehmen.
- Audio mit niedriger Bitrate oder schmalem Frequenzband, aus den oben genannten Gründen rund um die Abtastrate.
- Akzente und Dialekte, die in den Trainingsdaten eines Modells unterrepräsentiert sind. Das ist eine gut dokumentierte Schwäche von Sprachsystemen, kein Rundungsfehler.
- Fachjargon, Produktnamen, Abkürzungen und Nachnamen: wichtige Wörter, die in Trainingsdaten selten vorkommen.
- Hintergrundgeräusche und Sprachwechsel mitten im Satz, mit denen Modelle schlecht zurechtkommen, wenn sie nicht genau dafür gebaut sind.
Bevor Sie eine zweistündige Datei durchlaufen lassen, schneiden Sie die ersten drei Minuten heraus und transkribieren nur diese. Dann lesen Sie sie. Brauchen schon drei Minuten viel Nacharbeit, brauchen die restlichen 117 entsprechend mehr. Genau dann sollten Sie entscheiden: maschineller Durchlauf plus eigene Korrekturzeit oder gleich einen Menschen bezahlen.
Die Nacharbeit, die jedes Rohtranskript braucht
Die Rohausgabe jedes Transkriptionstools ist ein Datenhaufen, kein Dokument. Bis eine Kollegin es tatsächlich liest, braucht es einen bewussten Überarbeitungsdurchgang, und in dieser Reihenfolge geht er am schnellsten.
- Ordnen Sie zuerst die Sprecherbezeichnungen echten Namen zu. Jeder weitere Schritt fällt leichter, wenn Sie sehen, wer spricht, und ein globales Suchen und Ersetzen von „Sprecher 2“ kostet nichts.
- Korrigieren Sie die Eigennamen. Hier scheitert Transkription am vorhersehbarsten: Ihr Firmenname, Ihre Produktnamen, die Abkürzung, die Ihr Team vierzigmal am Tag sagt, der Nachname der Person im Call. Die Erkennung liegt dabei konsequent falsch und verunstaltet einen Begriff jedes Mal auf dieselbe Weise, sodass ein Suchen und Ersetzen pro Begriff meist alle Vorkommen bereinigt. Noch besser ist Vorbeugen: Mit einem eigenen Vokabular hinterlegen Sie Begriffe schon vor der Transkription, und genau dafür gibt es das Wörterbuch im KI-Meeting-Assistenten von Laxis.
- Entscheiden Sie sich für wörtlich oder geglättet und bleiben Sie dabei. Die wörtliche Fassung behält jedes Füllwort, jeden abgebrochenen Satzanfang und jede Wiederholung; das brauchen Sie für Forschung oder ein strittiges Protokoll. Die geglättete Fassung entfernt all das; das braucht jeder Text, der lesbar sein soll. Glätten Sie aber nicht zu stark: Auch Einschränkungen sind Inhalt. „Ich denke, wir schaffen das wahrscheinlich bis Freitag“ ist nicht dieselbe Zusage wie „Wir machen das bis Freitag“.
- Setzen Sie Absätze und Satzzeichen. Trennen Sie bei Themenwechseln, nicht bei jedem Sprecherwechsel, sonst wird ein schneller Schlagabtausch zu vierzig einzeiligen Absätzen.
- Setzen Sie Zeitstempel an Abschnittsgrenzen, damit jeder an die passende Stelle im Audio zurückspringen kann.
- Ziehen Sie Entscheidungen und Aufgaben mit den jeweiligen Verantwortlichen heraus. Das ist der Teil, den die Leute tatsächlich nutzen.
Wenn Sie lieber die Praxis als die Theorie wollen: Den gesamten Ablauf, um Audio in Text zu transkribieren, haben wir Schritt für Schritt beschrieben.
Audio in mehr als einer Sprache
Ist Ihre Aufnahme nicht oder nicht nur auf Englisch, etwa auf Deutsch, entscheiden zwei Fragen alles: Erkennt das Tool die Sprache selbst, und beherrscht es diese Sprache wirklich? Die Abdeckung schwankt stark. Dass eine Sprache auf einer Liste steht, heißt nicht, dass sie so gut transkribiert wird wie Englisch, denn die Trainingsdaten sind ungleich verteilt.
Laxis deckt über 100 Sprachen mit automatischer Spracherkennung ab und zeigt in Live-Meetings eine Live-Übersetzung neben dem Original, während gesprochen wird; im Business-Tarif wechselt Laxis innerhalb eines Meetings automatisch zwischen bis zu fünf Sprachen. Bei einer Datei, die Sie schon haben, halten Sie die richtige Reihenfolge ein: erst das Transkript korrigieren, dann übersetzen. Wer ein Transkript voller Erkennungsfehler übersetzt, erhält eine Übersetzung, deren Fehler niemand mehr zur Quelle zurückverfolgen kann.
Wie lange es dauert und was es kostet
Maschinelle Transkription braucht nur einen Bruchteil der Aufnahmedauer, für eine Stunde Audio meist wenige Minuten, manchmal länger, wenn Ihr Auftrag in einer Warteschlange steht. Bei menschlicher Transkription ist es umgekehrt: Wer abtippt, arbeitet langsamer als in Echtzeit, hält an, spult zurück und prüft Schreibweisen. Deshalb werden Lieferzeiten in Stunden oder Tagen angegeben und Preise pro Audiominute berechnet. Eilaufträge kosten mehr. Fragen Sie beim konkreten Anbieter nach der Preisliste, statt sich auf eine allgemeine Zahl zu verlassen, denn die Preise schwanken stark mit Lieferzeit, Audioqualität und Sprecherzahl.
Bei Software stoßen die meisten nicht an den Preis, sondern an die maximale Länge pro Aufnahme, die unabhängig vom monatlichen Minutenkontingent gilt. So sieht das bei Laxis aus, das neben Live-Meetings auch hochgeladene Audiodateien verarbeitet:
| Tarif | Preis | Was Sie bekommen |
|---|---|---|
| Basic (kostenlos) | 0 $ | 300 Transkriptionsminuten pro Monat, 45 Minuten pro Aufnahme |
| Premium | 15,99 $ pro Nutzer und Monat oder 9,99 $ bei jährlicher Abrechnung | 2.000 Transkriptionsminuten pro Monat, Aufnahmen bis 2 Stunden |
| Business | 29,99 $ pro Nutzer und Monat oder 19,99 $ bei jährlicher Abrechnung | Unbegrenzte Transkriptionsminuten, Aufnahmen bis 4 Stunden, dazu Sync mit HubSpot und Salesforce |
Die Grenze pro Aufnahme ist die, die viele überrascht. Ein dreistündiges All-Hands-Meeting passt weder in den Basic- noch in den Premium-Tarif. Sie teilen die Datei also auf oder wechseln in einen höheren Tarif. Und der CRM-Sync gehört zum Business-Tarif, nicht zu Premium. Das ist wichtig, wenn Sie Gespräche transkribieren, um sie in Ihre Pipeline zu bringen. Laxis läuft auf Desktop und Mobilgeräten, verbindet sich mit Zoom, Google Meet und Microsoft Teams und bietet eine Aufnahme ohne Bot, wenn Sie keinen sichtbaren Teilnehmer im Meeting haben möchten.
Wenn Sie Tools vergleichen wollen, statt ein konkretes Dateiproblem zu lösen, finden Sie die Kategorie im Vergleich der besten KI-Notizsoftware 2026 nebeneinander.
Wann sich ein Mensch statt Software lohnt
Für die meisten Aufnahmen ist Software die richtige Wahl. In manchen Fällen nicht, und es ist billiger, das offen zu sagen, als es auf die harte Tour herauszufinden.
Rechtliche und amtliche Protokolle. Zeugenvernehmungen, Gerichtsverfahren, Unterlagen für Behörden und alles, was als Beweismittel dienen könnte, erfordern in der Regel ein beglaubigtes Transkript einer qualifizierten Fachkraft, die die Richtigkeit bestätigt. Maschinelle Ausgabe ist kein beglaubigtes Protokoll, wie genau sie auch sein mag.
Schlechtes Audio, bei dem viel auf dem Spiel steht. Stammt die Aufnahme von einem einzigen, weit entfernten Mikrofon in einem halligen Raum mit viel Durcheinanderreden und ist der Inhalt wirklich wichtig, kosten Ihre Korrekturstunden mehr als eine Transkriptionskraft. Schätzen Sie den Aufwand ehrlich ein, bevor Sie sich entscheiden.
Ein starker Akzent, wenn es auf das Ergebnis ankommt. Die Erkennungsqualität ist je nach Akzent und Dialekt unterschiedlich. Kommt das Modell mit dem Akzent des Sprechers schlecht zurecht und wird das Transkript zitiert, als Grundlage verwendet oder dem Sprecher vorgelegt, beauftragen Sie einen Menschen.
Wörtliche Transkription für die Forschung. In der qualitativen Forschung, der Linguistik und manchen klinischen Arbeiten sind Zögern, Überlappungen und Selbstkorrekturen die eigentlichen Daten, kein Rauschen. Die Regeln für wörtliche Transkription sind genau festgelegt, und Maschinen wenden sie nicht an.
Regulierte Inhalte. Klären Sie die Compliance vor dem Hochladen, nicht danach. Laxis ist nicht HIPAA-konform und unterzeichnet keine Business Associate Agreements (BAAs), geschützte Gesundheitsdaten gehören also nicht hinein. Andere Tools gehen andere Verpflichtungen ein; verlässlich erfahren Sie das nur, wenn Sie den Anbieter schriftlich fragen.
Es gibt einen Mittelweg, der oft vergessen wird: erst der maschinelle Durchlauf, dann ein Mensch, der diesen Entwurf überarbeitet, statt alles von Grund auf abzutippen. Viele Dienste bieten das an, und es kostet weniger als eine komplett menschliche Transkription.
Beginnen Sie mit der Datei, die Sie schon haben
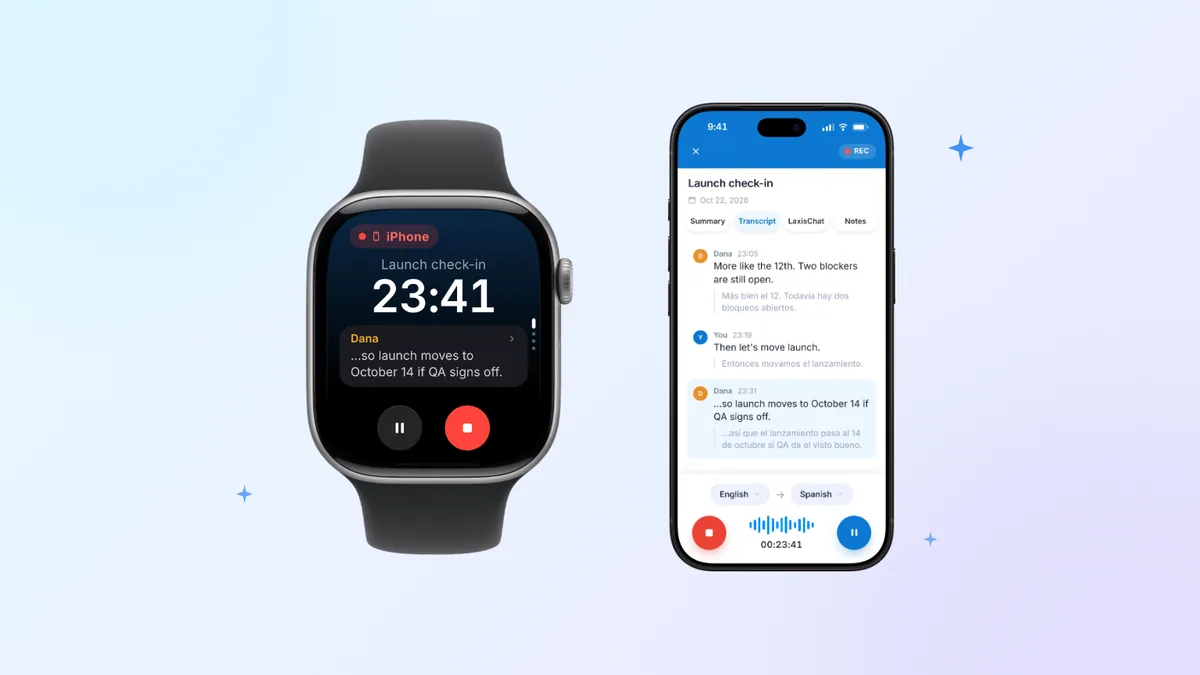
Liegt die Aufnahme gerade auf Ihrem Desktop? Dann laden Sie sie hoch, lesen Sie die ersten Minuten und finden Sie heraus, womit Sie es zu tun haben, bevor Sie entscheiden, wie viel Aufwand der Rest verdient. Der kostenlose Basic-Tarif von Laxis bietet 300 Transkriptionsminuten pro Monat mit höchstens 45 Minuten pro Aufnahme. Das reicht, um Ihre eigene schlechteste Aufnahme zu testen statt einer polierten Demodatei, und dabei läuft keine Testphase ab. Testen Sie es mit dem KI-Meeting-Assistenten von Laxis und beurteilen Sie das Ergebnis an Ihrem Audio, nicht an unserem.
Häufig gestellte Fragen
Was ist Audio-Transkription?
Audio-Transkription ist die Umwandlung aufgezeichneter Sprache in geschriebenen Text, entweder durch Spracherkennungssoftware oder durch einen Menschen, der abtippt. Die Eingabe ist eine Audiodatei wie mp3, m4a oder wav, das Ergebnis ist Text, meist mit Sprecherbezeichnungen und Zeitstempeln. Eine Zusammenfassung ist es nicht.
Welche Audioformate kann ich transkribieren?
mp3, m4a, aac und wav funktionieren zuverlässig in praktisch jedem Transkriptionstool, flac, ogg und opus meist ebenfalls. Video-Container wie mp4 und mov klappen in der Regel auch, weil das Tool die Tonspur extrahiert. Prüfen Sie das aber, bevor Sie eine sehr große Datei hochladen. DRM-geschütztes Audio lässt sich überhaupt nicht transkribieren.
Wie genau ist automatische Audio-Transkription?
Die Genauigkeit hängt weit mehr von Ihrer Aufnahme ab als vom gewählten Tool. Werbezahlen wie „99 % Genauigkeit“ werden auf Benchmark-Korpora mit sauber vorgelesener Sprache einer einzelnen Person gemessen, nicht in Besprechungsräumen. Rechnen Sie mit schlechteren Ergebnissen bei überlappenden Sprechern, einem weit entfernten Mikrofon, einem halligen Raum, ungewohnten Akzenten oder viel Fachjargon. Testen Sie zuerst drei Minuten Ihres eigenen Audios.
Kann Transkriptionssoftware Sprecher unterscheiden?
Ja, über die Sprechererkennung (Diarisierung): Sie gliedert das Audio danach, wer spricht, und benennt die Redebeiträge als Sprecher 1, Sprecher 2 und so weiter. Zuverlässig ist sie, wenn sich die Stimmen deutlich unterscheiden und nacheinander gesprochen wird; unzuverlässig bei Durcheinanderreden, ähnlich klingenden Stimmen oder einem einzigen Kugelmikrofon in einem großen Raum. Die Bezeichnungen echten Namen zuzuordnen, bleibt Ihre Aufgabe.
Kann ich eine bereits aufgenommene Audiodatei transkribieren?
Ja. Laxis verarbeitet hochgeladene Audiodateien, sodass sich eine Aufnahme vom Handy, von einer Konferenzplattform oder von einem eigenen Aufnahmegerät auch ohne Live-Meeting transkribieren lässt. Der kostenlose Basic-Tarif umfasst 300 Transkriptionsminuten pro Monat mit höchstens 45 Minuten pro Aufnahme; im Premium-Tarif steigt diese Grenze auf zwei Stunden, im Business-Tarif auf vier.
Wann sollte ich einen Menschen statt Software transkribieren lassen?
Beauftragen Sie einen Menschen für rechtliche und amtliche Protokolle, die beglaubigt werden müssen, für wörtliche Forschungstranskription, bei der Zögern und Überlappungen die Daten sind, und wenn schlechtes Audio und viel auf dem Spiel Ihre Korrekturzeit teurer machen würden als eine Transkriptionskraft. Ein praktischer Mittelweg: erst ein maschineller Durchlauf, dann überarbeitet ein Mensch diesen Entwurf.
Passendes Produkt
Laxis-Meeting-Assistent
Automatisieren Sie Ihre Notizen noch heute.
- Notizen ohne Bot für Zoom, Google Meet, Teams und Vor-Ort-Meetings
- KI-Zusammenfassungen, Aufgaben und Follow-ups in über 100 Sprachen
- Mac, Windows, iPhone und Android, mit kostenlosem Tarif
Kostenlos starten, keine Kreditkarte erforderlich.
Mehr erfahren ▷